目次
この記事の要点
- ナレッジエンジニアは専門家の知識と判断基準を引き出し、AIが使える形に変換する技術者
- 職種名の原典は1977年。AI研究者ファイゲンバウムがエキスパートシステム構築の担い手として定義した
- 当時から最大の難所は専門家から知識を引き出す「知識獲得」の工程で、この工程は今も自動化されていない
- 仕事内容は「引き出す」「構造化する」「AI資産化する」の3工程に分解できる
- 生成AIとRAGの普及で「AIに何を読ませるか」が成果を左右するようになり、知識を整える専門職が再評価されている
- なり方は隣接職種からの横展開が現実的。聞き出す技法と構造化の技術が核になる
「社内の資料は一通り読み込ませたのに、聞きたいことに答えてくれないんです」。「マニュアルに書いてある話は返ってくるのに、判断に迷う場面ほど一般論しか出てこない」。生成AIを業務に入れた職場で、こういう声を聞くことはないでしょうか。
まず疑うのはAIの側です。モデルを上位のものに替える、プロンプトを練り直す、読ませる文書を追加する。どれも自然な打ち手ですし、実際に効く場面もあります。
ただ、資料を足しても回答が一般論のままだと、現場は使うのをやめます。判断が要る場面ではやはりベテランに聞きに行く流れが戻り、質問はまた特定の人に集まります。導入した仕組みのほうは、試したところで止まったままです。
足りないのはモデルの性能ではなく、読ませる知識の側です。専門家の頭の中にあって、まだどこにも書かれていない判断を引き出し、AIが参照できる形に変換する。この工程を担う職種がナレッジエンジニア(knowledge engineer)で、職種名の原典は1977年、エキスパートシステムの時代までさかのぼります。当時から最大の難所だった「専門家から知識を引き出す工程」は、現在も自動化されていません。辞書と原典の定義、一度姿を消した経緯、仕事内容の3工程、生成AI・RAG時代に再注目される理由、必要なスキルとなり方までを順に解説します。
ナレッジエンジニアは専門家の知識をAIが使える形に変換する技術者である
辞書の定義でも対象は人工知能のシステム構築に置かれている
ナレッジエンジニアは専門家が頭の中で使っている知識と判断基準を引き出し、AIやシステムが参照できる形に変換する技術者です。国内の用語辞典も「エキスパートシステムの設計や構築を行う技術者。エキスパートシステムの開発には、人工知能の技術についての理解が必要なので、一般のシステムエンジニアとは区別される」と定義しています。
出典 ASCII.jpデジタル用語辞典 https://yougo.ascii.jp/caltar/ナレッジエンジニア
エキスパートシステムとは、専門家の知識をルールとして組み込み、専門家のように問題を解くことを目指した当時のAIシステムです。辞書の定義がいまもこの言葉で書かれているとおり、ナレッジエンジニアという職種名はエキスパートシステムの時代に生まれ、広まりました。職種を支える分野の側は、ナレッジエンジニアリング(知識工学)と呼ばれます。
職種名の原典は1977年のファイゲンバウム論文にある
職種としての原典をたどると、1977年の国際人工知能会議(IJCAI-77)に行き着きます。AI研究者のエドワード・ファイゲンバウムがこの会議で発表した論文が「The Art of Artificial Intelligence」です。論文は要旨の冒頭でこの職種を次のように定義し、後段に「2.2 The Knowledge Engineer」の節を置いています。
The knowledge engineer practices the art of bringing the principles and tools of AI research to bear on difficult applications problems requiring experts’ knowledge for their solution.
(ナレッジエンジニアは、解決に専門家の知識を要する困難な応用問題へ、AI研究の原理と手段を適用する技術を実践する者である)
出典 Edward A. Feigenbaum「The Art of Artificial Intelligence: 1. Themes and Case Studies of Knowledge Engineering」IJCAI-77 Proceedings・1977・pp.1014-1029 https://www.ijcai.org/Proceedings/77-2/Papers/092.pdf
注目したいのは、プログラムに詳しい人ではなく、専門家の知識を扱う人として定義されている点です。問題を解く力は推論の仕組みの強力さよりも専門家の知識に由来する、というのがこの論文を貫く考え方でした。だからこそ、知識を引き出してシステムに載せる専門の技術者が要る、という整理になります。1977年の定義ですが、社内の知見を生成AIに読ませようとして手が止まっている現在と、困っている場所は同じです。
ファイゲンバウムはその後、1994年にラジ・レディとともにACMチューリング賞を受賞しています。ナレッジエンジニアという職種名は、一時の流行語ではなく、AI研究の本流にいた研究者が定義した言葉だと分かります。
システムエンジニアとの違いは仕事の起点と成果物にある
ASCII.jpの定義には「一般のシステムエンジニアとは区別される」とありました。ナレッジエンジニアはシステムエンジニア(SE)の一種というより、起点と成果物が異なる別の役割です。定義に沿って整理すると次のようになります。
| 観点 | 一般のシステムエンジニア | ナレッジエンジニア |
|---|---|---|
| 仕事の起点 | 業務要件・仕様 | 専門家の知識・判断基準 |
| 主な仕事 | 要件をシステムとして設計・実装する | 知識を引き出し、AIが参照できる形に変換する |
| 主な成果物 | 動くシステム | 整備された知識(ナレッジベース・ルール・検索用データ) |
| 前提となる理解 | 業務プロセスとシステム開発 | 対象領域の知識とAIの仕組み |
システムエンジニアの仕事は、要件が言葉になっていることを前提にできます。ナレッジエンジニアの出発点は、まだ言葉になっていない知識です。要件定義の前に「要件のもとになる知識を人の頭の中から取り出す」工程が挟まる、と考えると違いをつかみやすいでしょう。実際には一人が両方を担う場合もありますが、工程としては別物です。
職種名が前面から消えたのは知識獲得のボトルネックに原因がある
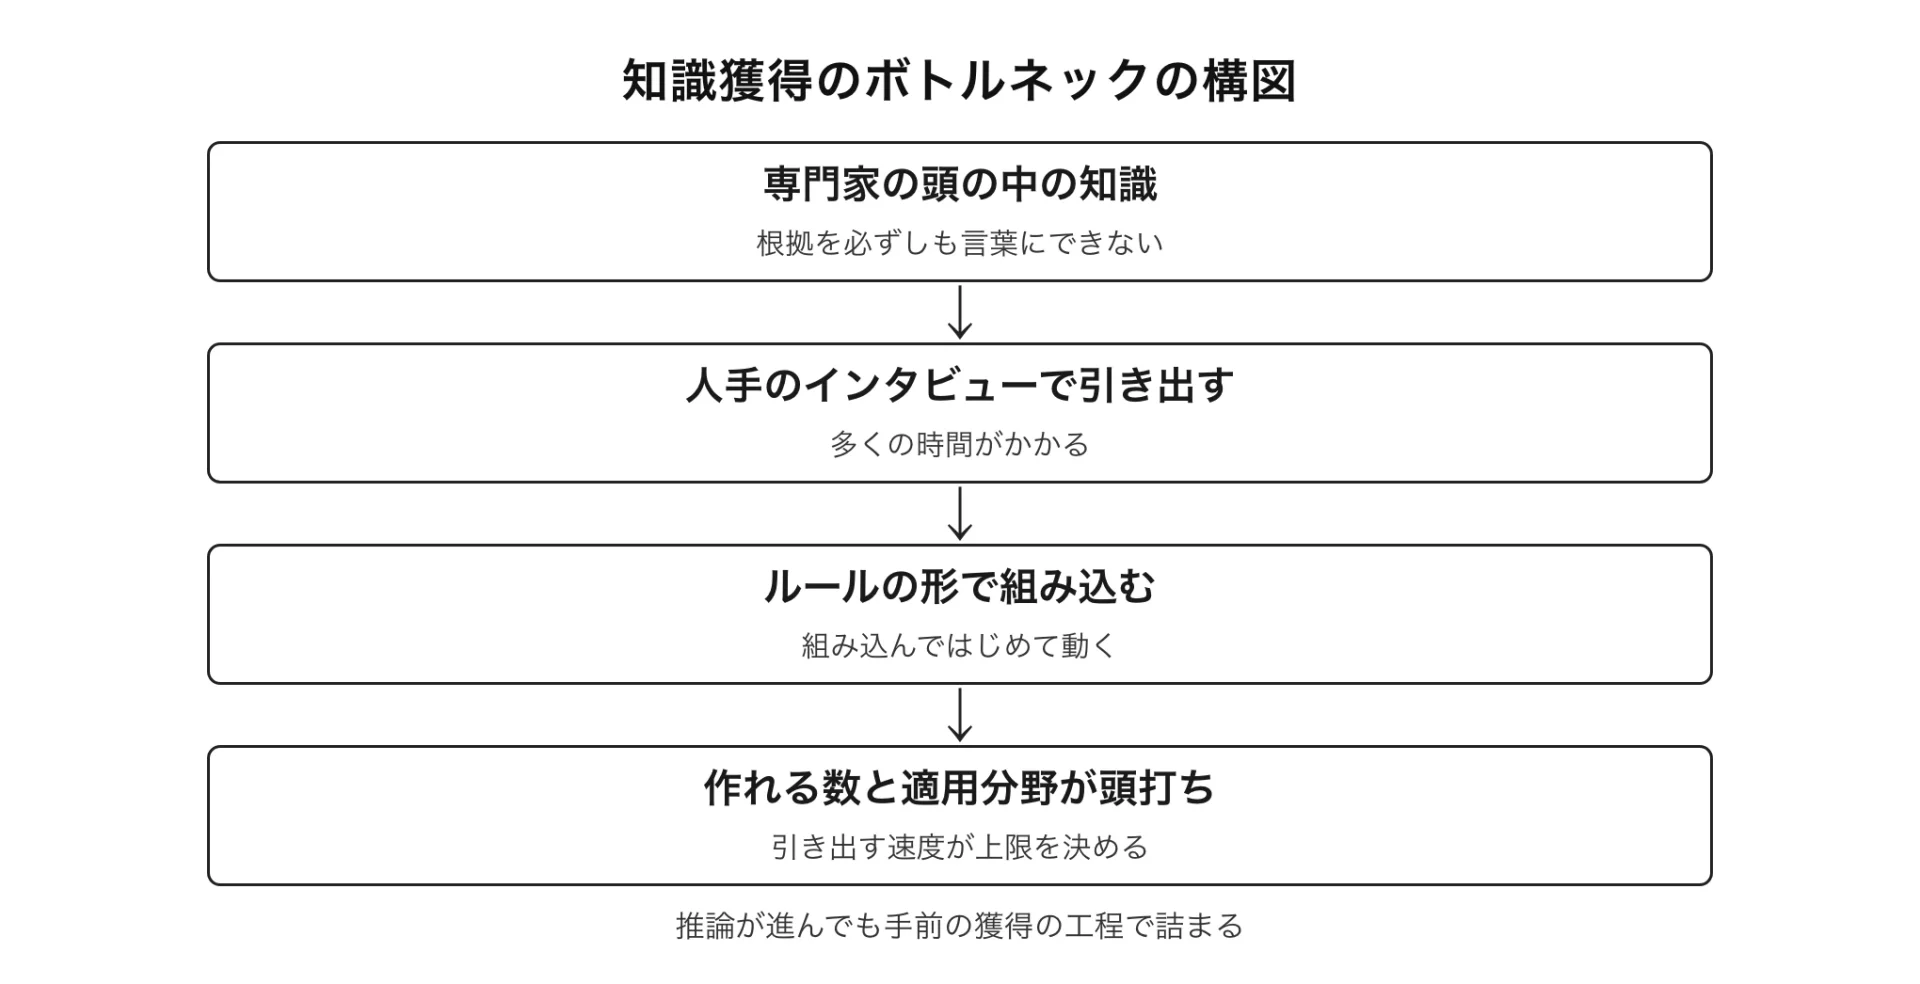
1977年に定義された職種が、なぜ長いあいだ前面に出てこなかったのか。理由は、定義した本人の論文にすでに書かれています。ファイゲンバウムは同じ論文で、応用指向の知的システムを作るうえで「ドメイン知識の獲得」こそがボトルネック問題だったと述べています。
出典 前掲Feigenbaum・1977
エキスパートシステムは、専門家の知識をルールの形で組み込んではじめて動きます。そしてルールを書くには、まず専門家から知識を引き出さなければなりません。この工程は人手のインタビューに頼るしかなく、多くの時間がかかります。しかも専門家は、自分の判断の根拠を必ずしも言葉にできません。知識を引き出す速度が上がらなければ、作れるシステムの数も、適用できる分野の広さも増えません。推論の仕組みがどれだけ進んでも、その手前の獲得の工程で詰まってしまいます。ファイゲンバウムはこの詰まりをボトルネックと呼びました。
その後の研究は、このボトルネックを軸に展開していきます。知識をどう引き出すかを扱う知識獲得の研究、引き出した概念の定義をどう揃えるかを扱うオントロジー工学へと続く流れです。
ボトルネックは、解決されて職種が要らなくなったのではなく、解決されないまま残りました。専門家から知識を引き出す工程は、その後のどの技術でも自動化されていません。ナレッジエンジニアという名前が表舞台から遠ざかったあとも、引き出す仕事そのものは、マニュアル作成や業務の引き継ぎという形で各職場に残り続けました。そして生成AIの登場で、この工程は「AIに何を読ませるか」という形で改めて表に出てきました。
仕事内容は引き出す・構造化する・AI資産化するの3工程に分かれる
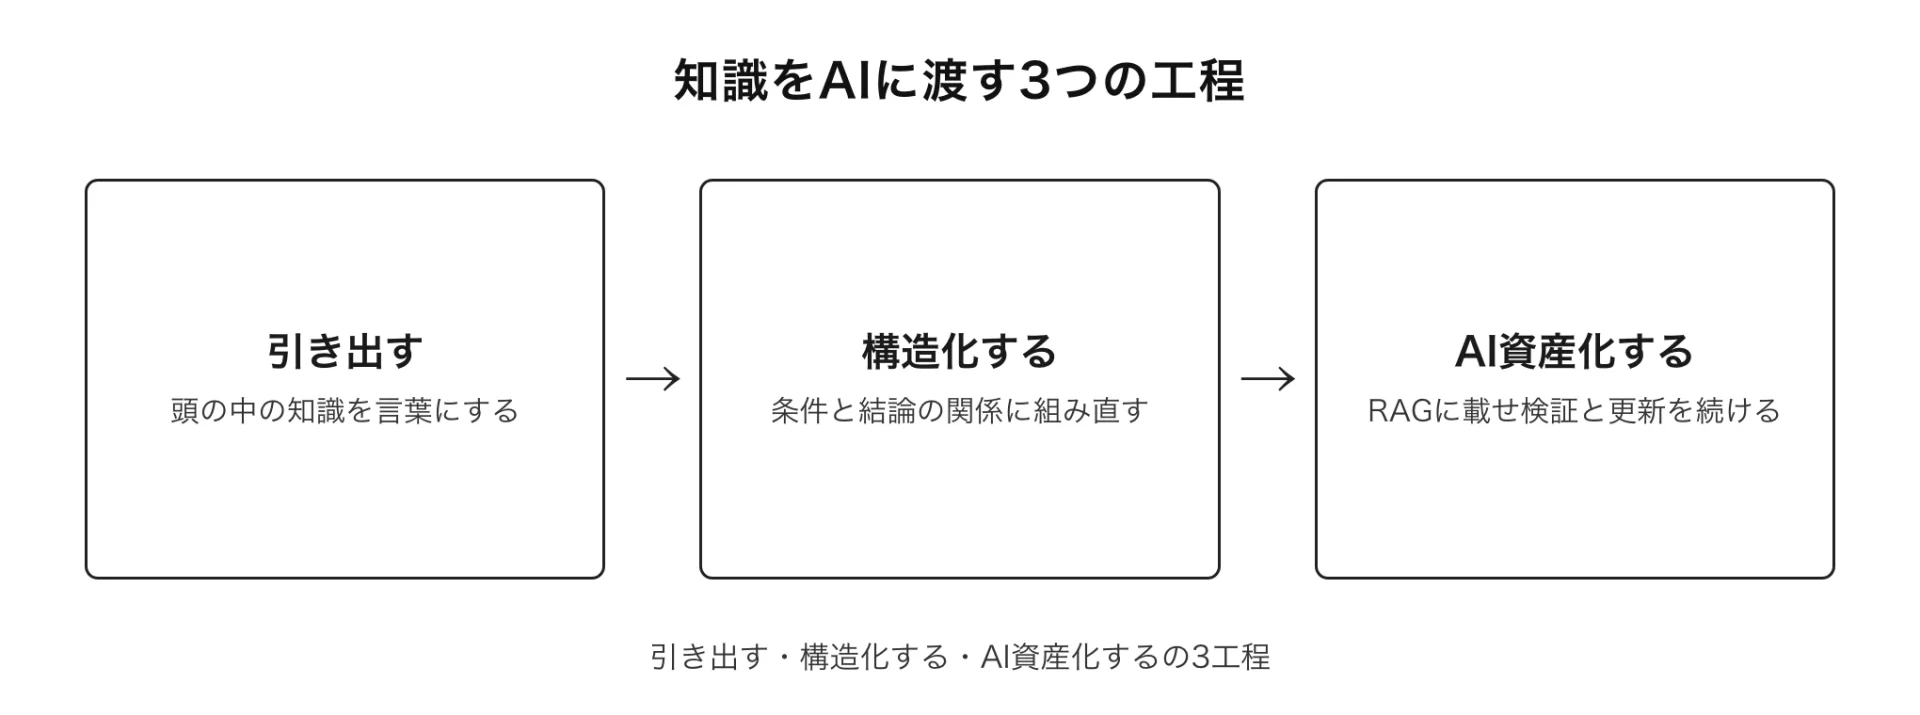
現在のナレッジエンジニアの仕事は、専門家の知識を「引き出す」「構造化する」「AI資産化する」という3つの工程に分解すると全体像をつかみやすくなります。
| 工程 | 何をするか | 主な成果物 |
|---|---|---|
| 1. 引き出す | 専門家へのインタビューなどで、頭の中の知識と判断基準を言葉にする | 事例の記録・判断基準の記述 |
| 2. 構造化する | ばらばらの記述を、条件と結論の関係が分かる形に組み直す | ナレッジベース・条件付きルール・用語定義 |
| 3. AI資産化する | RAGなどに載せ、回答のずれを検証しながら更新し続ける | AIが参照できる知識データと運用の仕組み |
引き出す コツを正面から聞いても一般論しか返ってこない
最初の工程は、知識獲得(knowledge acquisition)と呼ばれてきた仕事です。マニュアルや議事録としてすでに文書になっている知識なら、集めて整えれば済みます。実務で価値が大きいのは、まだ文書になっていない知識のほうです。ベテランがどの手がかりを見て、どこで線を引いているのか。どちらも本人に聞くしかありません。
ただし「コツを教えてください」と正面から聞いても、返ってくるのは一般論にとどまりがちです。哲学者のマイケル・ポランニーは、人は語れる以上のことを知っていると指摘しました(出典 Michael Polanyi『The Tacit Dimension』1966)。技能習得の研究でも、熟達するほど判断は意識的な比較検討を経ずに、状況全体をとらえた直観として下されるようになると整理されています(出典 Hubert Dreyfus & Stuart Dreyfus『Mind Over Machine』Free Press・1986)。本人が根拠をいちいち意識していない以上、聞き方を工夫しなければ言葉は出てきません。
知識獲得の研究では、質問の仕方そのものが方法として蓄積されてきました。代表例が、消防指揮官など時間圧の高い現場の判断研究から生まれたCDM(Critical Decision Method)です。実際にあった事例に沿って、何に気づき、どの選択肢を検討し、どこで決めたのかをたどる質問技法です。
出典 Klein, Calderwood & MacGregor「Critical decision method for eliciting knowledge」IEEE Transactions on Systems, Man, and Cybernetics・1989・pp.462-472 https://ieeexplore.ieee.org/document/31053/
ほかにも、うまくいった案件と見送った案件を対比する、条件がどこまで変わると判断が変わるかを探る、例外的な事例を集めて聞く、といった聞き方が使われます。こうした聞き方をまとめて認知タスク分析(CTA)と呼びます。
構造化する 判断は平均せず帰属を保ったまま条件付きルールにする
引き出した知識は、そのままでは長い語りの記録にすぎません。2つ目の工程では、これを条件と結論の関係が分かる形に組み直します。「この案件は通した」「あの案件は止めた」という事例の集まりから、どんな条件がそろったときにどう判断するのかを、条件付きのルールとして書き起こしていきます。
条件付きルールに書き起こすときに大切なのは、複数の専門家の判断を平均して1本にまとめないことです。同じ業務でも、人によって見ている手がかりや置いている前提は違います。誰の、どの条件での判断かという帰属を保ったまま残し、例外は例外として分けて書きます。基準が並んだままでは現場が迷うのではないか、と思われるかもしれません。ただ、混ぜて丸めてしまうと、その基準がどの状況で成り立つのかをあとからたどれなくなり、外れたときに直せなくなります。
用語の整理も構造化の一部です。同じ対象が部署ごとに違う名前で呼ばれていたり、同じ言葉が違う意味で使われていたりすると、後の工程で検索や参照が正しく働きません。概念どうしの関係を明示的に定義していくオントロジー設計は、知識工学がこの問題に対して発展させてきた技術です。
AI資産化する RAGに載せた時点では仕事は終わらない
3つ目の工程で、構造化した知識をAIが参照できる状態にします。代表的な仕組みがRAG(Retrieval-Augmented Generation・検索拡張生成)です。質問に関連する文書を検索で取り出し、その内容に基づいて回答を生成させる方法で、2020年に提案されました。
出典 Lewis et al.「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」NeurIPS 2020 https://arxiv.org/abs/2005.11401
RAGに載せた時点では、仕事はまだ終わりません。整備した知識でAIが実際に役立つ回答を返すか、専門家の見立てと突き合わせて確かめます。ずれの原因が知識の記述にあれば構造や書き方を直し、業務やルールが変わったら知識も更新します。AIは知識を参照して答えを組み立てる側であり、知識の正しさまで保証してくれるわけではありません。検証と更新を回し続ける運用の設計までが、AI資産化の仕事に含まれます。
再注目される理由は知識を獲得する工程だけが人に残ったことにある
生成と参照は進んだが獲得は自動化されていない
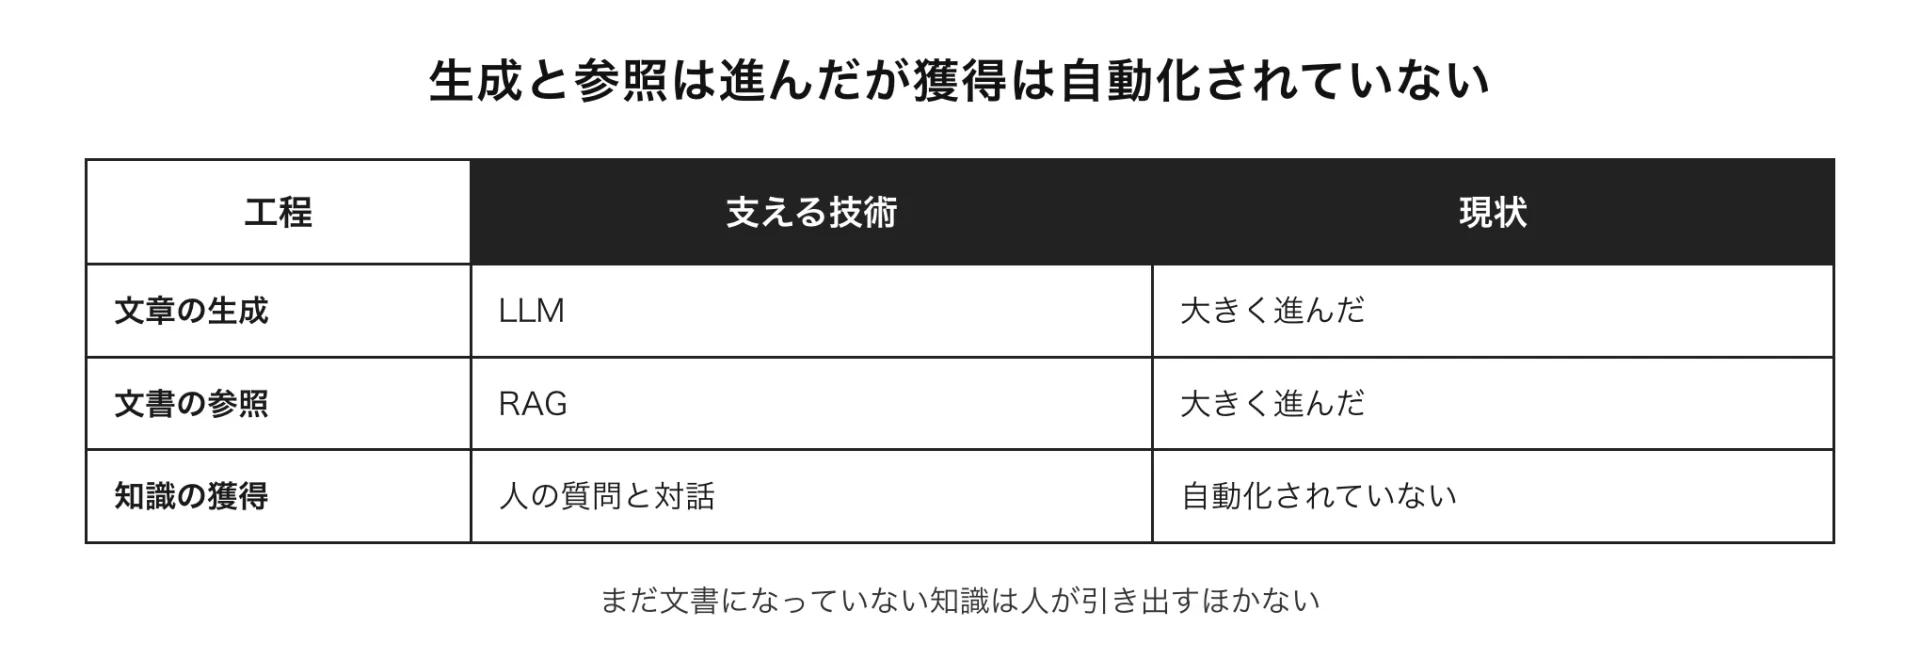
生成AIの普及で進んだのは、文章を生成する能力(LLM)と、手元の文書を参照して答える仕組み(RAG)です。一方、3工程の最初にある「専門家から知識を引き出す」工程は、いまも自動化されていません。AIは書かれた文書を読めますが、まだ書かれていない知識を専門家の頭の中から取り出す仕事は、依然として人の質問と対話に頼っています。
研究の側でも同じ見方が出ています。2023年の論文「Knowledge Engineering Using Large Language Models」は、LLMの登場は知識工学の基盤と実践を問い直すと述べました。そのうえで、記号的な知識表現とLLMを組み合わせるハイブリッド型の知識システムと、自然言語を介した知識工学という2つの方向を示しています。知識工学が不要になるのではなく、やり方を変えて続いていくという見取り図です。
出典 Allen, Stork & Groth「Knowledge Engineering Using Large Language Models」TGDK 1(1)・2023 https://drops.dagstuhl.de/entities/document/10.4230/TGDK.1.1.3
現場で不足しているのは手順ではなく例外時の判断基準である
再注目のもう一つの背景は、AIに読ませたい知識ほど文書に残っていないという現場の実情です。株式会社taiziiiの業務引き継ぎに関する実態調査では、引き継ぎで「これは教えておいてほしかった」と感じた観点の最多は「イレギュラーな状況や例外発生時の判断の基準」で、40.5%でした。
出典 株式会社taiziii「業務引き継ぎに関する実態調査」(従業員1,000名以上の大企業に勤務する管理職200名・インターネット調査・本調査2026年2月24日〜3月6日/追加調査2026年3月16日) https://taiziii.com/knowledge-transfer-survey-2026/ (公開ページは調査の概要とダウンロード案内で、設問ごとの数値は同ページで配布のレポートに掲載)
また、株式会社taiziiiが属人化と技術承継を対象に実施した別の調査では、特定の人にしか分からない属人化した業務が「ある」と答えた管理職は計70.5%でした。
出典 株式会社taiziii「企業の属人化・技術承継に関する実態調査」(管理職(課長以上)200名・インターネット調査・2025年8月14日〜18日実施) https://prtimes.jp/main/html/rd/p/000000005.000163598.html
手順書やFAQに載りやすいのは、決まった流れで進む定型の業務です。一方で引き継ぎの場面で足りなくなるのは、例外が起きたときにどこで線を引くかという判断の基準だった、というのが業務引き継ぎに関する実態調査(前掲)の結果でした。RAGは文書を検索して参照する仕組みなので、文書になっていない知識はそもそも参照できません。AIの導入を進めるほど、「読ませる知識を作る」工程が抜けていることがはっきりしてきます。ナレッジエンジニアの仕事は、この抜けている工程そのものです。
ナレッジマネジメントとの違いは活動の全体と工程という役割にある
ナレッジマネジメントは従業員の知識・経験を組織全体で共有し活用する経営手法です。制度づくりからツールの運用、共有する文化の醸成までを含む活動の全体を指します。ナレッジエンジニアはその全体像の中で、知識をAIやシステムが参照できる形に変換する工程を担う技術職にあたります。
| 比較の観点 | ナレッジマネジメント | ナレッジエンジニアの仕事 |
|---|---|---|
| 性格 | 経営手法・組織の活動 | 技術・工程 |
| 主な関心 | 知識を共有し活用する仕組みと運用 | 知識を引き出し、構造化し、AIに渡すこと |
| 主な担い手 | 経営層・管理部門を含む組織全体 | 技術者(専門家と協働する) |
両者は択一の関係ではありません。ナレッジ共有の取り組みが「貯めたのに使われない」「検索しても判断の答えが出てこない」で止まったとき、知識の形を変える工程を足すのがナレッジエンジニアの役割、という分担です。
ナレッジエンジニアに必要なスキルは4つに整理できる
中核になる4つのスキルのうち開発寄りは1つだけである
ここまでの3工程から逆算すると、必要なスキルは次の4つに整理できます。
| スキル | 内容 |
|---|---|
| 聞き出す技法 | 事例に沿って判断をたどる質問設計。相手が語れないことを前提に、対比や例外から引き出す |
| 構造化の技術 | 条件付きルールへの書き起こし、用語定義、ナレッジベースの設計。帰属を保ったまま整理する |
| RAG・LLMの理解 | AIが文書をどう参照し、どこで外すのかの理解。検証と更新の設計に直結する |
| 対象領域の理解 | 専門家と対話が成り立つ程度の業務知識。質問の質と構造化の精度を左右する |
4つのうち、開発寄りのスキルはRAG・LLMの理解だけです。残りの3つは、聞く、整理する、業務を知るという能力で、開発経験がなくても積み上げていけます。3工程のうち2つまでが、コードを書く前の仕事だからです。
求人を待つより隣接職種から地続きで入るほうが現実的である
親和性の高い入り口は4つあり、いまの経験のどこがそのまま活きて何を足すことになるかが、それぞれ違います。
- システムエンジニアから。要件を聞き出して形式化する経験は、そのまま知識獲得に活きます。足すのは、要件の手前にある判断を引き出す技法とRAGの理解です。
- データ整備・データ基盤の担当から。データを検索・参照できる形に整える仕事は、AI資産化の工程と重なります。対象を数値データから知識と判断基準に広げる入り方です。
- ナレッジマネジメント・マニュアル担当から。社内のどこに何が文書化され、何が抜けているかを知っている立場は、引き出す対象の特定で強みになります。
- 現場の専門家から。自分の領域の知識を自ら構造化する入り方です。4つのスキルのうち最も習得に時間がかかる対象領域の理解を、すでに持っています。
どの入り口から入る場合も、始め方は同じです。ベテランの判断に頼っている業務を一つ選び、その人に事例ベースで話を聞き、判断の条件を書き起こしてみる。引き出して構造化するというこの職種の中核工程を、そのまま小さく試したことになります。
よくある質問
ナレッジエンジニアリング(知識工学)とは何が違うのか
ナレッジエンジニアリングは分野・技術の名前で、ナレッジエンジニアはそれを実践する職種の名前です。1977年のファイゲンバウムの論文も、題名では分野を指してknowledge engineeringと呼び、その実践者をknowledge engineerと書き分けています(出典 前掲Feigenbaum・1977)。分野としては、エキスパートシステムから知識獲得の研究、オントロジー工学を経て、LLMやRAGの文脈で再び参照される流れをたどっています。
生成AIが進化すればナレッジエンジニアは不要になるのか
研究側で示されているのは、知識工学がなくなるという見方ではありません。記号的な知識表現との組み合わせや、自然言語による知識工学へと実践の形が変わる、という方向です(出典 前掲Allen, Stork & Groth・2023)。少なくとも現時点で、専門家の頭の中からまだ文書になっていない知識を引き出す工程は自動化されていません。AIが強力になるほど読ませる知識の質が結果を左右するため、知識を整える役割は生成AIと競合するものではなく、生成AIを活かす前提側にあると整理できます。
未経験からナレッジエンジニアになるには何から始めればよいか
隣接する経験を核にして、足りない要素を足していく入り方が現実的です。開発経験があるなら知識獲得の技法を、業務の専門性があるなら構造化とRAGの基礎を足します。職種名の付いた求人を探すことだけが入り口ではありません。いまの職場で、特定の人に依存している業務の判断基準を聞き出して書き起こす経験を作れば、それがこの仕事の最初の実績になります。
知識を整える工程がAI活用の前提になる
ナレッジエンジニアとは、専門家の知識を引き出し、構造化し、AIが参照できる資産に変換する技術者です。1977年にファイゲンバウムが定義した職種であり、当時から最大の難所は専門家から知識を引き出す知識獲得の工程でした。このボトルネックは解決されないまま残り、生成AIとRAGが普及した現在、「AIに何を読ませるか」という形で改めて表面化しています。
生成と参照の技術は進みました。それでも、まだ文書になっていない知識、とりわけ例外時の判断基準のような知識は、人が引き出して整えるほかありません。自社のAI活用が「検索しても欲しい答えが出ない」で止まっているなら、足りないのはモデルの性能ではなく、この変換の工程かもしれません。まずは、特定の人の判断に依存している業務を一つ選び、その知識がどこまで文書になっているかを確かめることから始めてみてください。
関連記事
- ナレッジエンジニアリング(知識工学)とは エキスパートシステムから生成AIまで
- 認知タスク分析(CTA)とは 熟達者の判断を引き出す質問の方法
- 暗黙知はAIで形式知化できるのか
- 暗黙知の形式知化はなぜ失敗するのか
- ナレッジマネジメントとは何か
SNSでシェアする


各種お問い合わせ