目次
この記事の要点
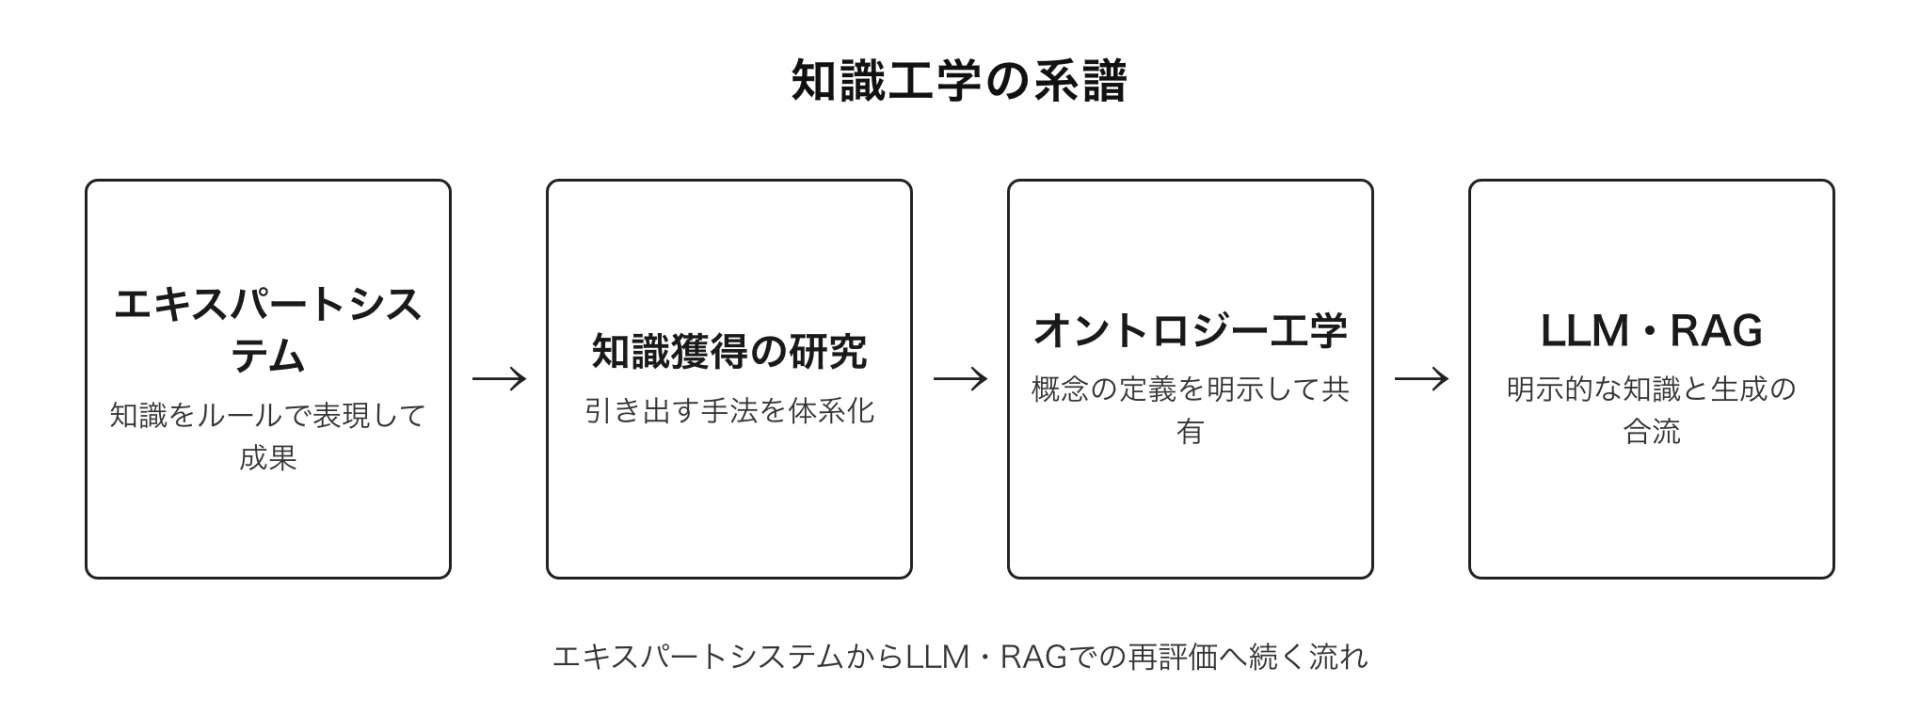
- ナレッジエンジニアリング(知識工学)は、専門家の知識をコンピュータが扱える形に変換し、難しい問題を解くシステムを作る技術領域。1977年にファイゲンバウムが職能として体系化した
- DENDRALやMYCINといった初期のエキスパートシステムは、専門家の知識をIF-THENルールで表現して成果を上げた。導かれた原則は「力は知識にある」
- ブームの壁は推論技術ではなく「専門家から知識を引き出す」工程。ファイゲンバウム自身がドメイン知識の獲得をボトルネックと名指しした
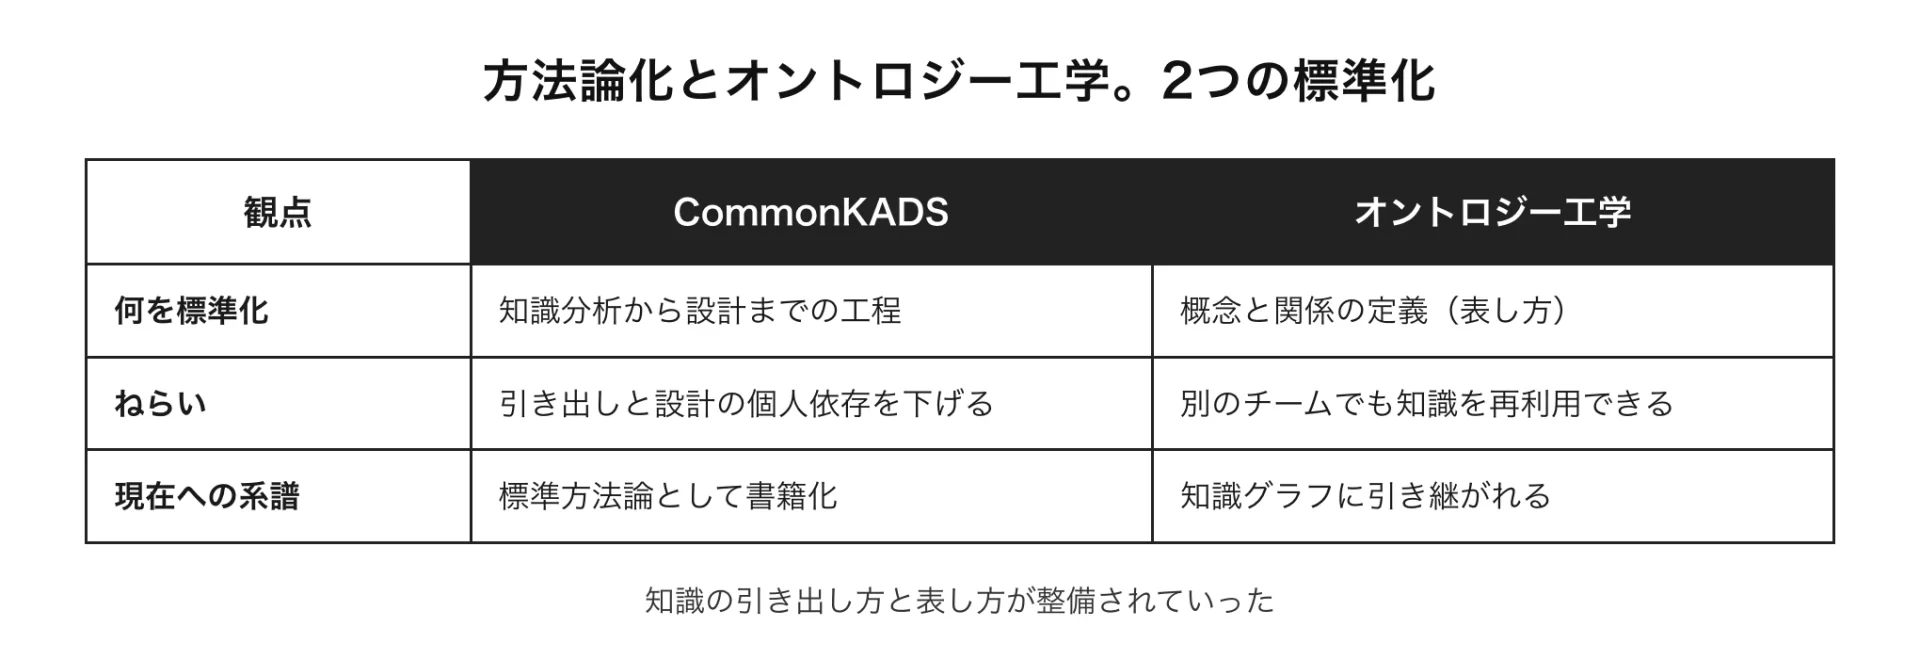
- 挫折の後、CommonKADSによる方法論の標準化と、オントロジー工学による知識表現の整備が進んだ
- LLM・RAGの登場で知識工学は再評価されている。知識グラフとの統合と「自然言語による知識工学」が研究の焦点
- 知識獲得のボトルネックは現在も残る。RAGに参照させる知識を誰がどう引き出すかが、AI導入の実務を左右する
1982年に始まった第五世代コンピュータプロジェクトには、1992年度の終了までに約540億円が投じられました。成果として残ったのは、512プロセッサ構成のPIM/pをはじめとする5モデルの並列推論マシンです。その5年前の1977年、エドワード・ファイゲンバウムはすでに論文で、応用向けの知的システムを作るうえでのボトルネックは推論の仕組みではなくドメイン知識の獲得のほうだと指摘していました。予算と人が向かった先は推論を速く大きくする方向で、詰まっていたのはその手前でした。
出典 情報処理学会コンピュータ博物館「第五世代コンピュータ」 https://museum.ipsj.or.jp/computer/other/0002.html /Edward A. Feigenbaum, “The Art of Artificial Intelligence: 1. Themes and Case Studies of Knowledge Engineering”, IJCAI-77 Proceedings, 1977 https://www.ijcai.org/Proceedings/77-2/Papers/092.pdf
社内の知識を生成AIに参照させるときも、最初に手をつけるのは検索の側です。社内文書をまとめて登録し、分割の仕方や検索の設定を調整し、モデルを選び直す。順当な進め方で、定型の問い合わせにはよく効きます。
それでも、例外案件の線引きや優先順位のつけ方を聞くと、返ってくるのは当たり障りのない一般論です。手順書に書いてあることは答えられても、書いていないことは答えられません。使う人は次第に離れ、判断が要る場面ではやはりベテランに確認の連絡をすることになります。
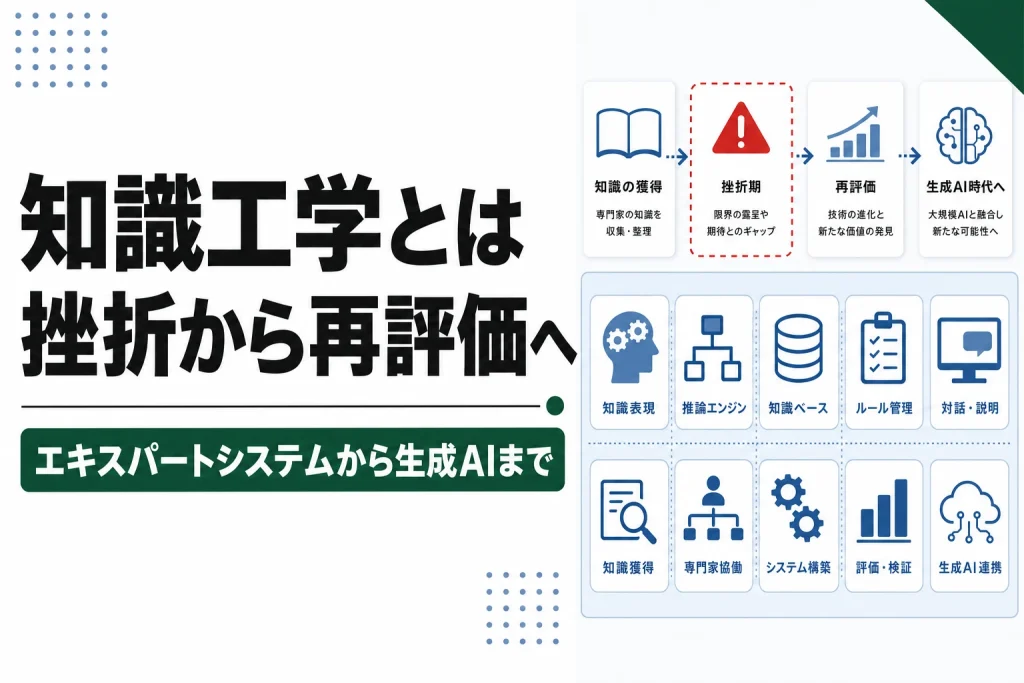
詰まっている場所は1977年と同じです。検索や生成の技術ではなく、参照させる知識を誰がどう引き出すか。この問いを正面から扱ってきた技術領域が、ナレッジエンジニアリング(知識工学)です。1970年代にエキスパートシステムとともに確立し、ブームと挫折を経て方法論とオントロジー工学に発展し、いまLLMやRAGの文脈で再び参照されています。原典の定義、エキスパートシステムの成果、知識獲得のボトルネック、CommonKADSとオントロジー、LLM・RAGでの再評価までを、一続きの歴史として解説します。
ナレッジエンジニアリング(知識工学)は知識を機械が扱える形に変換する技術領域である
定義の原典は1977年のファイゲンバウム論文にある
ナレッジエンジニアリング(knowledge engineering)は、日本語では「知識工学」と訳されます。専門家の知識を要する難しい問題にAI研究の原理と手段を適用し、問題を解くシステムを作る技術領域です。この定義の原典は、計算機科学者エドワード・ファイゲンバウム(Edward A. Feigenbaum)が1977年の国際AI会議IJCAI-77で発表した論文「The Art of Artificial Intelligence: 1. Themes and Case Studies of Knowledge Engineering」にあります。ファイゲンバウムは後の1994年にラジ・レディとともにACMチューリング賞を受賞した、この分野を代表する研究者です。
論文はこの技術の担い手を「ナレッジエンジニア」と呼び、次のように定義しています。”The knowledge engineer practices the art of bringing the principles and tools of AI research to bear on difficult applications problems requiring experts’ knowledge for their solution.”(ナレッジエンジニアは、解決に専門家の知識を要する困難な応用問題へ、AI研究の原理と手段を適用する技術を実践する)。
出典 Edward A. Feigenbaum, “The Art of Artificial Intelligence: 1. Themes and Case Studies of Knowledge Engineering”, IJCAI-77 Proceedings, 1977, pp.1014-1029 https://www.ijcai.org/Proceedings/77-2/Papers/092.pdf
実務の言葉に置き換えると、次の一連の工程を指します。専門家は長年の経験で身についた知識を使い、診断や分析のような難しい問題を解いています。その知識は本人の頭の中にあり、そのままではコンピュータで動きません。そこで専門家から知識を聞き出し、コンピュータが処理できる形式(当時は主にIF-THENルール)に書き換え、推論の仕組みと組み合わせてシステムに仕立てる。この「引き出す・変換する・組み込む」の全体が知識工学です。
この分野の主な節目は次のとおりです。
| 年 | 出来事 |
|---|---|
| 1965年 | DENDRALプロジェクト開始(スタンフォード大学の質量分析研究室と共同) |
| 1977年 | ファイゲンバウムが知識工学を主題とした論文をIJCAI-77で発表。「知識獲得のボトルネック」もここで指摘 |
| 1982〜1992年度 | 第五世代コンピュータプロジェクト(予算約540億円) |
| 1989年 | 判断を引き出す面接手法CDMの論文(クラインら) |
| 1993年 | グルーバーによるオントロジーの定義(Knowledge Acquisition誌) |
| 2000年 | 標準方法論CommonKADSの書籍がMIT Pressから刊行 |
| 2020年 | RAGの原典論文(NeurIPS 2020) |
| 2023〜2024年 | LLM時代の知識工学再評価(TGDK創刊号論文・IEEE TKDEロードマップ論文) |
ナレッジマネジメントとの違いは「対象」ではなく「方法」にある
似た言葉にナレッジマネジメントがありますが、扱う対象が重なる一方で性格が異なります。ナレッジマネジメントは、従業員一人ひとりの知識・経験を組織全体で共有し、業務改善や価値創造に活かす経営手法です。制度・運用・場の設計が中心で、経営学の系譜に属します。ナレッジエンジニアリングは、知識をコンピュータが扱える形式に変換してシステムに組み込む工学で、AI研究の系譜に属します。同じ「専門家の知識」を扱っていても、前者は人と組織の仕組みに、後者は知識の表現と変換の技術に力点があります。
| 観点 | ナレッジエンジニアリング(知識工学) | ナレッジマネジメント |
|---|---|---|
| 性格 | AI研究から生まれた工学・技術領域 | 経営学から生まれた経営手法 |
| 目的 | 専門家の知識を機械が扱える形にして問題を解かせる | 組織の知識を共有・活用して業務を改善する |
| 主な成果物 | ルール・オントロジー・知識ベース | 共有の制度・運用・ツール活用 |
| 代表的な系譜 | エキスパートシステム→知識獲得→オントロジー工学 | 組織的知識創造理論(1990年代)以降の実践 |
生成AIの導入では、この2つが同じ場所でぶつかります。経営手法として集めてきた知識をAIに参照させる段になると、その知識をどんな形式で書き表すかという工学側の問いを避けて通れなくなるからです。
エキスパートシステムの成果は知識を明示的なルールとして書き出せたことにある
DENDRALとMYCINは専門家の知識をIF-THENルールで表現した
知識工学の出発点は、特定分野の専門家と同じ水準で問題を解くことを目指した「エキスパートシステム」です。ファイゲンバウムの1977年論文は、その代表例としてDENDRALとMYCINをケーススタディに挙げています。
DENDRALは1965年に始まった化学分野のプロジェクトで、スタンフォード大学の質量分析研究室と共同で進められました。同論文はこれを「AI史上最も長く続いた継続的取り組みの一つ」と記しています。
MYCINは血液感染症の診断を扱う医療分野のシステムです。専門医の知識をIF-THENルール、つまり「もし条件1と条件2が成り立つなら、結論Xを支持する」という形式の規則として蓄積し、推論に使いました。同論文には実際に使われたルールの一つ(RULE 85)がそのまま掲載されています。それまで専門医の頭の中にしかなかった知識を、第三者が検証も再利用もできる明示的なルールの集合として書き出せるようになりました。ここがエキスパートシステムの大きな前進です。
出典 前掲Feigenbaum 1977(DENDRAL・MYCINのケーススタディ)
力は知識にある。システムの能力は推論手法より知識の質で決まる
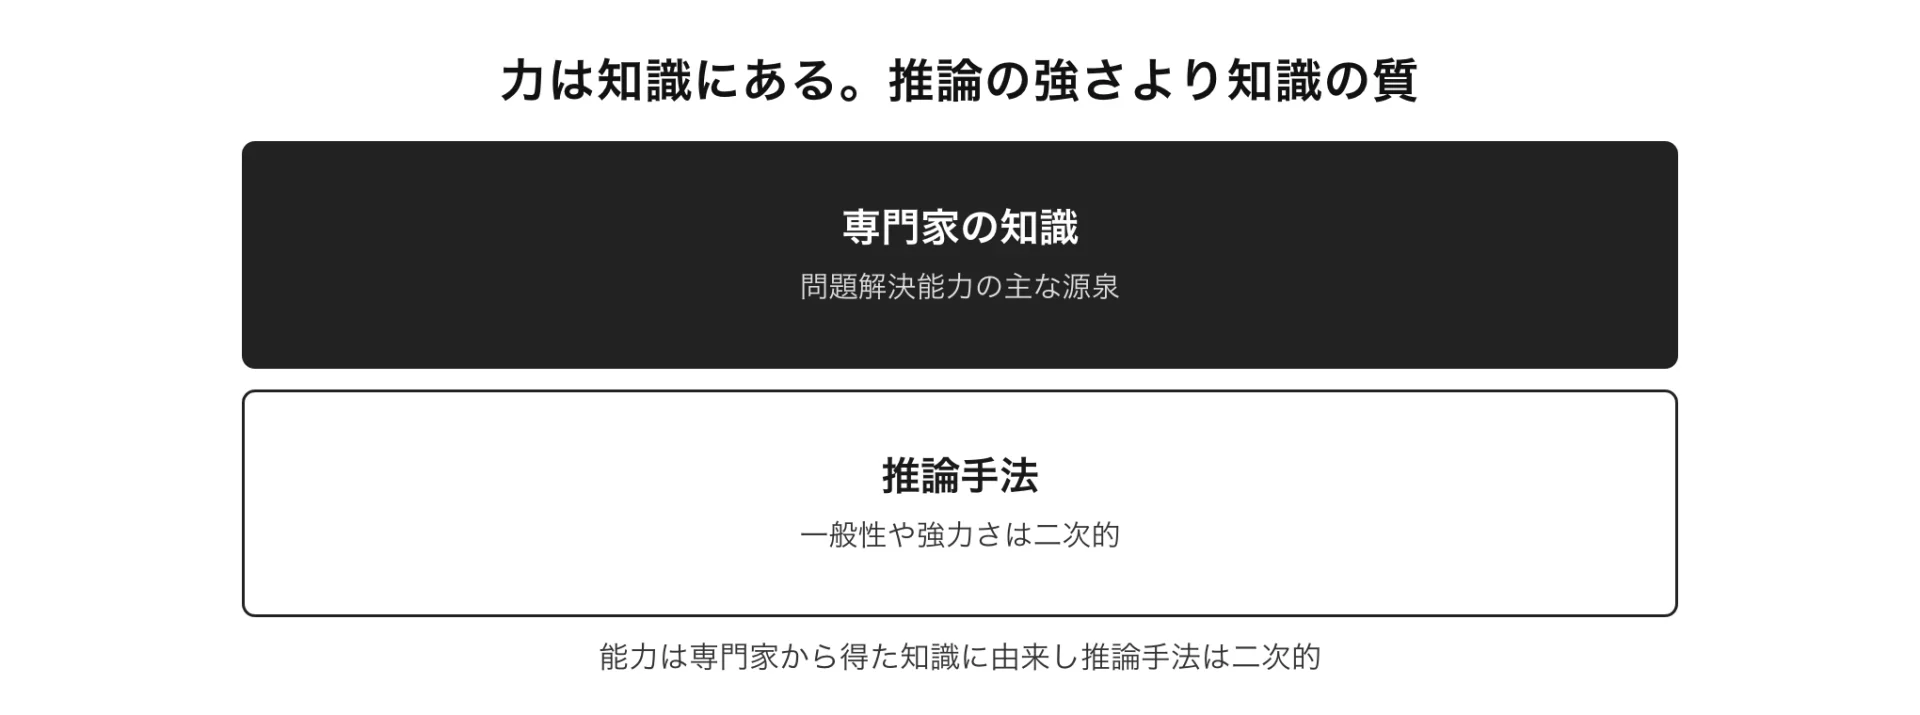
エキスパートシステムの経験から導かれた原則が、同論文にある”in the knowledge is the power”(力は知識のほうにある)という一文です。システムの問題解決能力は主として専門家から得た知識に由来し、推論手法の一般性や強力さは二次的だ、という趣旨が述べられています。
出典 前掲Feigenbaum 1977
この原則は、知識工学という仕事がなぜ要るのかをそのまま説明しています。優れたシステムを作る鍵は、アルゴリズムを磨くことより、質の高い専門知識をどれだけシステムに移せるかにあります。だとすれば、専門家から知識を引き出して変換する工程こそが最も重要な工程になります。そして、まさにその工程が最大の壁になりました。
ブームが終わったのは推論技術ではなく知識獲得のボトルネックに原因がある
壁はブームが本格化する前の1977年にすでに名指しされていた
エキスパートシステムは1980年代に企業や研究機関へ広がり、1990年代にかけて期待が落ち着いていきました。ただし、つまずきの核心が後から判明したわけではありません。ファイゲンバウムはブームが本格化する前の1977年の論文で、すでにこう書いています。”the acquisition of domain knowledge was the bottleneck problem in the building of applications-oriented intelligent agents”(ドメイン知識の獲得こそが、応用指向の知的エージェントを構築するうえでのボトルネック問題だった)。
出典 前掲Feigenbaum 1977(§3.2.1)
ルールを処理する技術より、ルールのもとになる知識を専門家から引き出す工程のほうが難しい、という指摘です。専門家へのインタビューを重ねても、判断の根拠が思うように言葉になりません。哲学者マイケル・ポランニーは「人は語れる以上のことを知っている(We can know more than we can tell)」と述べ、熟達した人の知識には本人も言語化しきれない層(暗黙知)があることを指摘しました。インタビューの回数を重ねても言葉にならない部分が残るのは、聞き手の力量ではなく知識の側の性質によります。
出典 Michael Polanyi, *The Tacit Dimension*, Doubleday & Company, 1966
第五世代コンピュータプロジェクトの投資は推論を速くする方向へ向かった
日本もこの時代の当事者でした。1982年、通商産業省(現在の経済産業省)の主導で第五世代コンピュータプロジェクトが始まります。推進母体は新世代コンピュータ技術開発機構(ICOT)。「知識情報処理を指向した新しいコンピュータ技術の研究開発」を技術目標に掲げ、1992年度の終了までに約540億円が投じられました。成果としては、512プロセッサ構成のPIM/pをはじめとする5モデルの並列推論マシンが残っています。
出典 情報処理学会コンピュータ博物館「第五世代コンピュータ」 https://museum.ipsj.or.jp/computer/other/0002.html /電子情報通信学会マイルストーン https://www.ieice.org/jpn_r/assets/pdf/publication/milestone/d47-48.pdf
第五世代コンピュータプロジェクトの成否そのものより、見ておきたいのは投資の向きです。並列推論マシンという成果が示すとおり、プロジェクトの中心は「推論を速く、大規模にする」方向の技術開発でした。一方でファイゲンバウムが名指しした壁は、専門家の頭の中から知識を引き出すという、計算機の性能とは別種の問題です。力は知識のほうにあるという原則に立てば、推論をいくら強化しても、入れるべき知識が引き出せなければシステムは賢くなりません。ブームが去った後に研究が向かった先も、この「引き出す」と「表す」の2つの工程でした。
挫折の後に進んだのは知識の引き出し方と表し方の標準化である
CommonKADSは知識獲得を個人の力量から工程の問題へ置き直した
エキスパートシステムの反省を最も体系的に引き継いだ成果の一つが、CommonKADSと呼ばれる方法論です。シュライバー(Schreiber)ら7名の著書『Knowledge Engineering and Management: The CommonKADS Methodology』(MIT Press、2000年)にまとめられており、産学のコンソーシアムが約10年をかけて開発しました。扱う範囲が広く、組織のどの知識が重要かを見立てる知識マネジメントの段階から、知識の分析、システムの設計までを一続きの工程として置いています。
出典 Schreiber, Akkermans, Anjewierden, de Hoog, Shadbolt, Van de Velde & Wielinga, *Knowledge Engineering and Management: The CommonKADS Methodology*, MIT Press, 2000 https://direct.mit.edu/books/monograph/3278/
この方法論の意味は、知識の分析からシステムの設計までを、決まったモデル群に沿って進む標準の工程として書き下したことにあります。工程が標準化されていれば、知識の引き出しと設計が特定の開発者の経験に依存する度合いを下げられます。知識獲得のボトルネックを、個人の力量の問題ではなく、方法論で扱う工程の問題へ置き直した回答といえます。
オントロジーは知識の土台そのものを共有できる資産にする考え方である
知識の「表し方」の側でも標準化が進みました。計算機科学者トマス・グルーバー(Thomas R. Gruber)は1993年の論文で、オントロジーを「概念化の明示的な仕様(an ontology is an explicit specification of a conceptualization)」と定義しました。
出典 Thomas R. Gruber, “A translation approach to portable ontology specifications”, *Knowledge Acquisition*, 5(2), 1993, pp.199-220 https://tomgruber.org/writing/ontolingua-kaj-1993/
ある領域で使う概念(たとえば「顧客」「契約」「与信枠」)と概念どうしの関係を、人にも機械にも読める形で明示的に定義した仕様、と言い換えられます。定義が明示されていれば、別のシステムや別のチームが同じ知識を再利用できます。個別のシステムごとに知識表現を作り直すのではなく、知識の土台そのものを共有できる資産にする、という考え方です。オントロジー工学と呼ばれる分野に発展し、概念と関係をグラフ構造で表す現在の知識グラフ(ナレッジグラフ)に引き継がれています。
LLM・RAGの時代に知識工学は置き換えではなく組み合わせとして再評価されている
LLMと知識工学が交わる合流点はRAGと知識グラフの2つである
生成AIに社内文書を参照させる代表的な手法がRAG(Retrieval-Augmented Generation、検索拡張生成)です。LLMが答えを作る際に外部の文書を検索して参照させる枠組みで、原典はルイスらが2020年のNeurIPSで発表した論文です。モデルの学習だけに頼らず、外部に置いた知識を参照して答えの根拠にする構図がここで確立しました。
出典 Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, NeurIPS 2020(*Advances in Neural Information Processing Systems* 33, pp.9459-9474) https://arxiv.org/abs/2005.11401
もう一つの合流点が知識グラフです。パンらは2024年、LLMと知識グラフを相互に補完させながら統合していく研究のロードマップを、IEEEの論文誌で整理しました。言語を柔軟に扱えるLLMと、明示的で検証しやすい知識を持つ知識グラフを、対立ではなく組み合わせの関係として描く流れです。
出典 Pan et al., “Unifying Large Language Models and Knowledge Graphs: A Roadmap”, *IEEE Transactions on Knowledge and Data Engineering*, 36(7), 2024, pp.3580-3599 https://doi.org/10.1109/TKDE.2024.3352100 (オープンアクセス版 arXiv:2306.08302)
知識工学の研究者たち自身も、この状況を正面から論じています。アレンらは2023年の論文「Knowledge Engineering Using Large Language Models」で、LLMの登場は知識工学の基盤と実践を問い直すものだとし、今後の方向として2つを挙げました。ニューラルネットと記号的な知識表現を組み合わせるハイブリッド知識システムと、自然言語を使って知識工学の作業そのものを進める「自然言語による知識工学」です。ルールやオントロジーを人手で書いてきた時代の蓄積と、言語を直接扱えるLLMは、どちらかが他方を置き換えるのではなく、組み合わせて使うものとして位置づけられています。
出典 Allen, Stork & Groth, “Knowledge Engineering Using Large Language Models”, *TGDK(Transactions on Graph Data and Knowledge)*, 1(1), 2023 https://drops.dagstuhl.de/entities/document/10.4230/TGDK.1.1.3
知識を入れることとAIがそれを使えることは別である
長い文脈を扱えるLLMが登場すると、知識は整理せずそのまま全部渡せばよいのではないか、という発想が出てきます。この発想の限界を示した研究が、リウらの「Lost in the Middle」です。関連する情報が長い入力文脈の中央付近に置かれるとモデルの性能が落ち、文脈の先頭と末尾にあるときは高くなりました。つまり情報の位置に対して性能がU字型のカーブを描く、という報告です。
出典 Liu et al., “Lost in the Middle: How Language Models Use Long Contexts”, *Transactions of the Association for Computational Linguistics*, 12, 2024, pp.157-173 https://aclanthology.org/2024.tacl-1.9/
長い文脈にまとめて渡せば済むわけではない以上、どの知識を、どう構造化して、どこに置くかという設計は残ります。知識の表現と整理という知識工学の古典的な主題は、LLMの時代にも回答の質を左右し続けています。
1977年の指摘は対象を変えて現在のAI導入にも残っている
知識獲得のボトルネックは消えていない
エキスパートシステムの時代と現在では、知識の「入れ方」が大きく変わりました。違いと共通点を並べると次のようになります。
| 観点 | エキスパートシステム(1970〜80年代) | LLM・RAG(現在) |
|---|---|---|
| 知識の表現 | IF-THENルールなどの明示的な記号表現 | 文書・知識グラフとモデルのパラメータ |
| 知識の入れ方 | ナレッジエンジニアが専門家から聞き取りルール化 | 文書を検索対象に登録し、生成時に参照させる |
| 答えの出し方 | ルールに基づく推論 | 検索と生成の組み合わせ |
| 変わらない課題 | 専門家からの知識獲得(ボトルネック) | 参照させる知識を誰がどう引き出すか |
ルールを手で書く必要がなくなった分、導入の入り口は広がりました。しかしRAGが参照できるのは、文書になっている知識だけです。手順書・規程・FAQのようにすでに文書がある知識は、登録すれば検索と生成の対象になります。一方、例外案件の線引きや優先順位のつけ方のような判断は、そもそも文書が存在しないことがあります。存在しない文書は、どれだけ検索技術を高めても出てきません。
ドメイン知識の獲得がボトルネックだという1977年の指摘は、ルールを書く場面から、AIに参照させる知識を用意する場面へと対象を変えて残っています。エキスパートシステムの失敗から教訓を一つ選ぶなら、検索や推論の技術より先に、知識を引き出す工程を設計することです。
知識獲得研究の系譜は判断の引き出しに続いている
ボトルネックは放置されてきたわけではありません。これを解くために、専門家から知識を引き出す手法の研究(knowledge acquisition、知識獲得)が発達しました。代表例がCDM(Critical Decision Method)です。専門家の現場判断を研究した心理学者ゲイリー・クラインらが1989年に発表した面接手法で、過去の重要な判断場面を取り上げ、プローブ質問と呼ばれる問いを重ねて判断の手がかりを引き出します。消防指揮官や救急救命士など、時間圧の高い現場の専門家に適用されてきました。
出典 Klein, Calderwood & MacGregor, “Critical decision method for eliciting knowledge”, *IEEE Transactions on Systems, Man, and Cybernetics*, 19, 1989, pp.462-472 https://ieeexplore.ieee.org/document/31053/
エキスパートシステムから知識獲得、そしてオントロジー工学へ。この系譜で積み上げられた「引き出し方」は、現在の実務では専門家の判断を言語化する場面に引き継がれています。判断に迷った案件を時系列で振り返る。対照的な2つの事例を並べ、判断が分かれた条件を聞く。条件がどこまで変われば結論が変わるかを確かめる。こうした聞き方はいずれも知識獲得研究で体系化されてきたもので、まとめて認知タスク分析(Cognitive Task Analysis、CTA)と呼ばれます。
引き出した判断の残し方にも注意点があります。複数の専門家の判断を平均して一本のルールにまとめないことです。判断は人と条件に結びついています。基準が人ごとに分かれたままでは運用できないのではないか、と思われるかもしれません。ただ、誰の、どの条件での判断かという帰属を保ったまま条件付きのルールとして残すほうが、外れたときに原因をたどれますし、条件が変われば該当するルールだけを更新できます。知識を引き出す工程の設計と、帰属を保った残し方。この2つが、エキスパートシステム以来の研究蓄積から現在のAI導入が受け取れる実務的な教訓です。
よくある質問
ナレッジエンジニアリングとナレッジマネジメントはどう違うのか
ナレッジエンジニアリングは、専門家の知識を機械が扱える形に変換してシステムを作る工学です。ナレッジマネジメントは、組織の知識を共有・活用する経営手法で、制度や運用の設計が中心になります。扱う対象は重なりますが、前者はAI研究、後者は経営学の系譜に属します。
エキスパートシステムと生成AIは何が違うのか
エキスパートシステムと生成AIでは、知識の持ち方が違います。エキスパートシステムは、専門家から聞き取った知識をIF-THENルールとして明示的に書き、ルールに基づいて推論します。生成AIは、大量のテキストから学習したモデルが言語を生成し、RAGを使う場合は外部の文書を検索して参照します。一方で共通点もあります。どちらも結果の質が、与えられた知識の質に左右される点です。ファイゲンバウムが力は知識のほうにあると述べた原則は、生成AIの導入にも当てはまると考えられます。
知識獲得のボトルネックとは何を指すのか
知識獲得のボトルネックとは、エキスパートシステムを作る工程のうち、専門家から知識を引き出してシステムに移す部分が全体の進みを決めてしまう、という問題です。ファイゲンバウムが1977年の論文で指摘しました。専門家の知識には本人も言語化しにくい暗黙知が含まれるため、インタビューを重ねるだけでは引き出しきれないことが背景にあります。この構造は、生成AIに参照させる知識を用意する現在の実務にも残っています。
ナレッジエンジニアとはどのような職種か
ナレッジエンジニアは、専門家の知識を引き出し、機械が扱える形に変換してシステムに組み込む技術者です。1977年のファイゲンバウムの論文で職能として定義されました。エキスパートシステムの時代に生まれた職種ですが、LLM時代の知識工学を問い直す研究(前掲Allen et al. 2023)が出るなど、役割は再評価されつつあります。実務では、専門家から判断を引き出す工程と、引き出した内容をAIが参照できる形に構造化する工程の両方を担います。
知識工学を学ぶには何から読めばよいのか
一次資料の多くが無料で公開されています。出発点にはファイゲンバウムの1977年論文(IJCAI-77、PDF公開)が適しています。知識工学を職能として定義した原典であり、DENDRAL・MYCINのケーススタディも収められています。方法論を体系的に押さえるなら『Knowledge Engineering and Management: The CommonKADS Methodology』(MIT Press、2000年)、LLM時代との接続を知るならアレンらの2023年論文(オープンアクセス)が読みやすい選択です。
知識工学は過去の学問ではなくAI導入に続く蓄積である
ナレッジエンジニアリング(知識工学)は、専門家の知識をコンピュータが扱える形に変換して問題を解かせる技術領域です。1965年開始のDENDRALに始まり、MYCINなどのエキスパートシステムで成果を上げ、1977年にファイゲンバウムが職能として体系化しました。ブームの中心で壁になったのは推論技術の不足ではなく、専門家から知識を引き出す工程、すなわち知識獲得のボトルネックでした。その反省からCommonKADSという標準方法論とオントロジー工学が生まれ、知識の引き出し方と表し方が整備されていきました。
そして現在、LLMとRAGの登場でこの蓄積が再び参照されています。知識グラフとの統合や自然言語による知識工学という研究の流れは、古い技術の復権ではなく、明示的な知識と生成モデルの合流です。同時にLost in the Middleが示すとおり、知識を入れることと使われることは別であり、知識の構造化という古典的な主題は残り続けています。
これからAIに社内の知識を参照させるなら、順序が大切です。まず、すでに文書になっている知識と、まだ専門家の頭の中にある判断を分けます。前者は登録と検索の整備で進みます。後者には、知識獲得研究が積み上げてきた「引き出す工程」の設計が必要です。1977年に名指しされたボトルネックを知っておくことが、同じつまずきを繰り返さないための備えになります。
関連記事
- ナレッジエンジニアとは 仕事内容とAI時代に再注目される理由
- 認知タスク分析(CTA)とは 熟達者の判断を引き出す質問の方法
- 生成AI時代のナレッジマネジメントとは
- 暗黙知の形式知化はなぜ失敗するのか
- ナレッジマネジメントとは何か
SNSでシェアする


各種お問い合わせ