目次
この記事の要点
- AI Readyとは、必要なときに直ちにAIを導入し便益を得られる状態を指す言葉。2019年の政府決定文書と経団連提言に由来する公的な概念
- 生成AIの回答が外れる主因はモデルの性能ではなく、参照させる社内データの状態にある
- RAGの精度低下の典型は、散在・古い・出典不明・判断基準の欠落の4つ
- AIが参照して外さないナレッジの条件は、構造化・鮮度・出典・判断基準の明文化の4つに整理できる
- 整備は、業務の棚卸し→文書の仕分け→書き直しとメタ情報付与→測定と更新運用の4ステップ
- 最初の対象は全社データ基盤ではなく、問い合わせの多い業務から絞るのが現実的
AIを導入した企業は増えましたが、期待した成果まで届いた企業は限られます。情報処理推進機構(IPA)が2026年7月16日に公表した調査(回答企業1,799社)では、AI導入は大企業を中心に広がる一方、効果が期待どおり・期待以上だったとする回答の割合は限定的でした。活用の中心も、業務の効率化・迅速化にとどまっています。
出典 情報処理推進機構(IPA)「プレス発表 国内企業のDX動向・AI活用動向のポイントを公表」2026年7月16日 https://www.ipa.go.jp/pressrelease/2026/press20260716.html
この落差を埋めようとするとき、最初に疑われるのはAIモデルの性能です。高性能なモデルに乗り換え、別のツールと比べ、プロンプトを工夫します。規程やマニュアルをまとめて読み込ませ直す手入れもよく行われます。
ところが、モデルを替えても答えは一般論のままです。同じ主題の文書が複数拾われて、聞くたびに答えが変わります。更新の止まったマニュアルが、現行の情報として答えの根拠になります。判断を問う質問には、どこにも書かれていないため教科書的な回答しか返りません。やがて現場はAIを開かなくなり、整備にかけた工数だけが残ります。
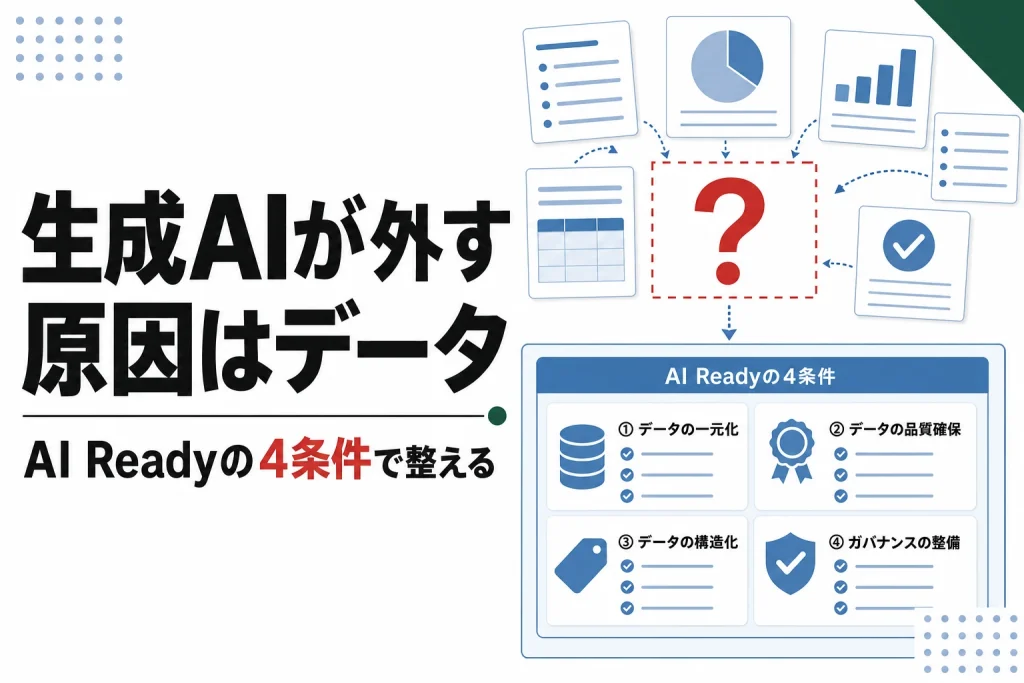
外しているのはモデルではなく、渡している社内データの側です。この記事では、AIを活用できる状態を指す「AI Ready」という概念を整理し、AIが参照して外さないナレッジの4条件(構造化・鮮度・出典・判断基準の明文化)、整備を進める4つの手順、最初に手を付ける業務の選び方までを扱います。
AI Readyとは導入して直ちに成果につなげられる状態である
AI Readyという言葉が指すのは、AIを導入すれば直ちに活用でき、便益を得られるところまで組織とデータの準備が整っている状態です。もともとは社会全体の変革を語る文脈で生まれ、現在は企業や組織の単位でも「自社はAI Readyか」という形で使われています。
AI Readyの出どころは2019年の政府決定文書と経団連提言にある
AI Readyという言葉が広まった起点は2019年です。統合イノベーション戦略推進会議が同年3月に決定した「人間中心のAI社会原則」は、「AI-Readyな社会」を、必要なときに直ちにAIを導入して恩恵を得られる社会と定義しています。同じ年の2月には経団連も提言「AI活用戦略」で「AI-Readyな社会」の実現を掲げ、企業・個人・社会制度と産業基盤の3つのレベルで必要な変革を整理しました。
出典 統合イノベーション戦略推進会議「人間中心のAI社会原則」(2019年) https://www8.cao.go.jp/cstp/ai/aigensoku.pdf /日本経済団体連合会「AI活用戦略~AI-Readyな社会の実現に向けて~」(2019年) https://www.keidanren.or.jp/policy/2019/013.html
企業の単位に引きつけると、AI Readyとは、AIツールを導入したときに自社のデータ・業務・体制がそれに対応でき、成果につなげられる状態です。データが電子化されているという意味ではありません。電子化された文書が大量にあっても、AIが参照して使える状態になっているとは限らないからです。
近年は、AIの導入を個別ツールの話ではなく、管理の仕組みとして扱う整理も進んでいます。米国NISTのAIリスクマネジメントフレームワーク(AI RMF)や、AIマネジメントシステムの国際規格ISO/IEC 42001が整備され、AI活用にはリスクの把握から更新・検証までを含む体制が要るという考え方が、国際的な枠組みとして示されています。AI Readyを考えるときも、データの状態に加えて、誰が管理し、どう更新し、どう検証するかまでを含めて捉える必要があります。
出典 NIST「AI Risk Management Framework」 https://www.nist.gov/itl/ai-risk-management-framework /ISO「ISO/IEC 42001(AIマネジメントシステム規格)」 https://www.iso.org/standard/81230.html
ツールを導入済みでもAI Readyとは限らない
導入の有無とAI Readyかどうかは、別々に確かめる必要があります。情報処理推進機構(IPA)が2026年7月16日に公表したプレス発表(回答企業1,799社・2026年4〜6月調査)によると、AI導入は大企業を中心に拡大し一定の効果実感もみられる一方、効果が期待どおりや期待以上だったとする回答の割合は限定的で、活用は業務の効率化・迅速化が中心にとどまります。
出典 情報処理推進機構(IPA)「プレス発表 国内企業のDX動向・AI活用動向のポイントを公表」2026年7月16日 https://www.ipa.go.jp/pressrelease/2026/press20260716.html
導入と成果の間にあるものは何でしょうか。同じツールを入れても、AIに参照させるデータの状態は会社ごとに違います。生成AIは渡されたデータの範囲でしか答えられないため、データが整っていない会社では、高機能なツールを入れても一般論の域を出ない答えが返り続けます。AI Readyかどうかを分けるのは、導入したツールの数や新しさではなく、AIに渡せる状態のデータと、それを保つ運用がどれだけあるかです。生成AIの普及で知識の共有や蓄積がどう変わったかは、別記事「生成AI時代のナレッジマネジメント」で扱っています。
生成AIの回答が外れる原因はモデルではなく渡すデータにある
社内データを活用する生成AIの回答品質は、モデルの性能と参照データの品質の掛け合わせで決まります。このうち実務で差がつくのは、ほとんどの場合データの側です。
RAGの精度が上がらないのは参照データの品質に原因がある
社内文書に基づいて生成AIに答えさせる仕組みは、RAG(検索拡張生成)と呼ばれます。動きは二段構えです。質問を受けると、まず登録された文書群から関係しそうな箇所を検索し、次に見つかった箇所を根拠として答えを組み立てます。答えの材料になるのは検索で見つかった文書だけです。参照先に書かれていないことは答えに現れず、参照先が古ければ答えも古くなります。
RAGの精度を上げたいときに見直す先も、この二段構えの前半にあります。モデルを高性能なものに替えても、検索して渡される文書が同じなら、答えの材料は変わりません。古い文書は古い答えの根拠になり続け、書かれていない判断基準は答えに現れないままです。RAGの精度低下に悩んだら、モデルの乗り換えを検討する前に、参照データの状態を確かめるのが順序です。
社内データが「ある」のに使えない4つの典型
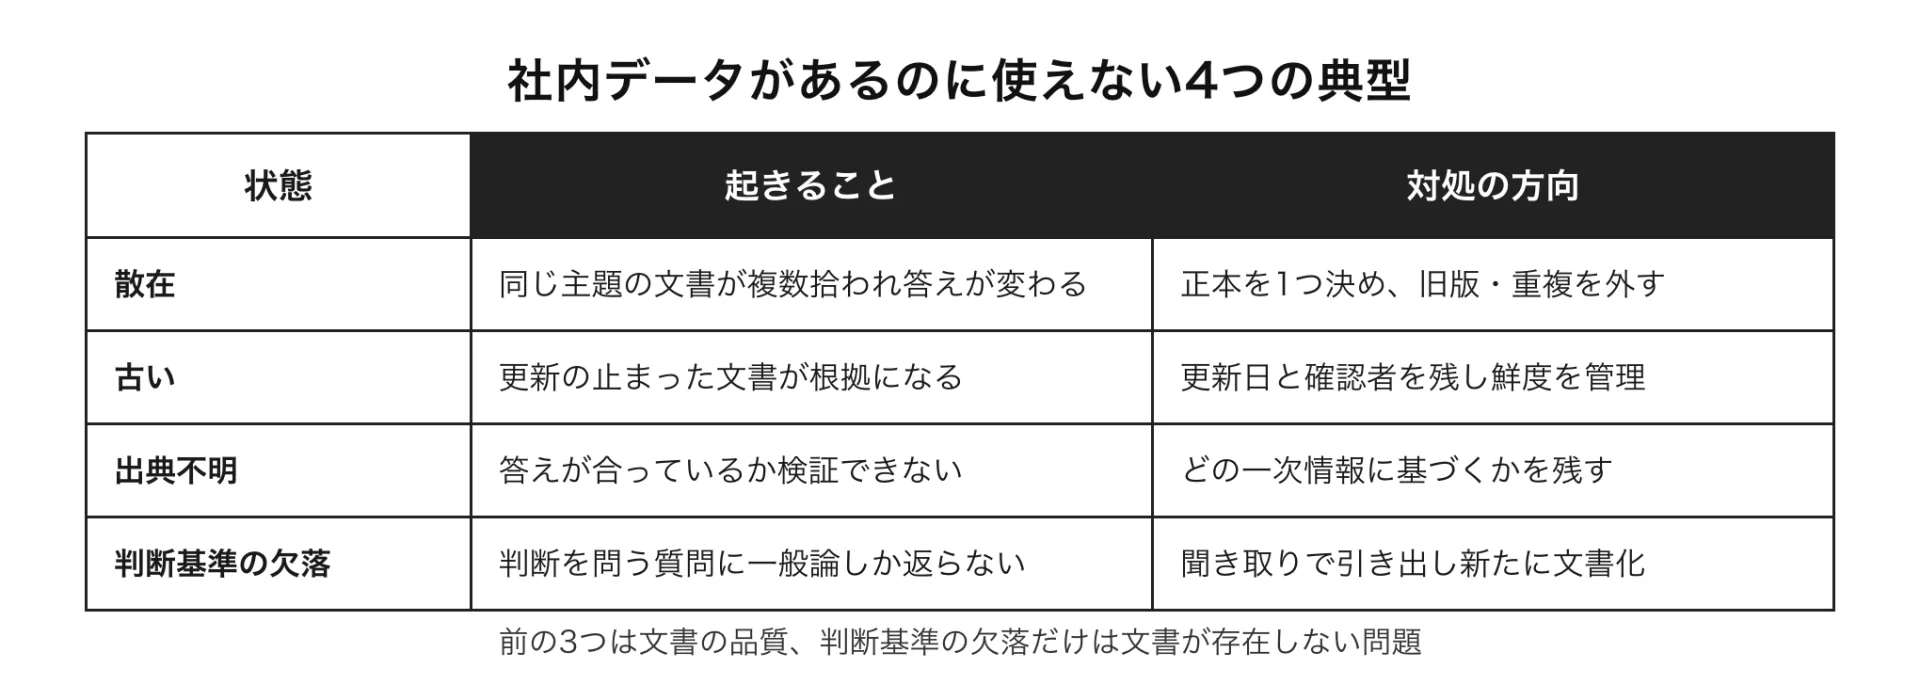
社内にデータは十分あるはずなのに、AIの答えが業務に使えない。そうしたとき参照データの側で起きていることは、おおむね次の4つに集約されます。
| 状態 | 起きること | 対処の方向 |
|---|---|---|
| 散在 | 同じ主題の文書が複数拾われ、質問のたびに答えが変わる | 正本を1つ決め、旧版・重複を参照対象から外す |
| 古い | 更新の止まった文書が現行の情報として答えの根拠になる | 更新日と確認者を残し、鮮度を管理する |
| 出典不明 | 答えが合っているかを人が検証できない | どの一次情報に基づくかを文書に残す |
| 判断基準の欠落 | 判断を問う質問に一般論しか返らない | 聞き取りで引き出し、新たに文書化する |
前の3つは、既にある文書の品質の問題です。正本を決め、更新し、根拠を書き足せば改善できます。4つ目の判断基準の欠落だけは性質が違い、必要な文書がそもそも存在しない問題です。存在しないものは整理しても現れないため、整備手順でも扱いが分かれます。
ツールを選ぶ段階では、この4つを避けられるかどうかが確認点になります。回答の参照元を表示できるか、閲覧権限を反映できるか、文書の更新を検索側に反映できるかを見ます。
AI Readyなナレッジは構造化・鮮度・出典・判断基準の4条件に整理できる
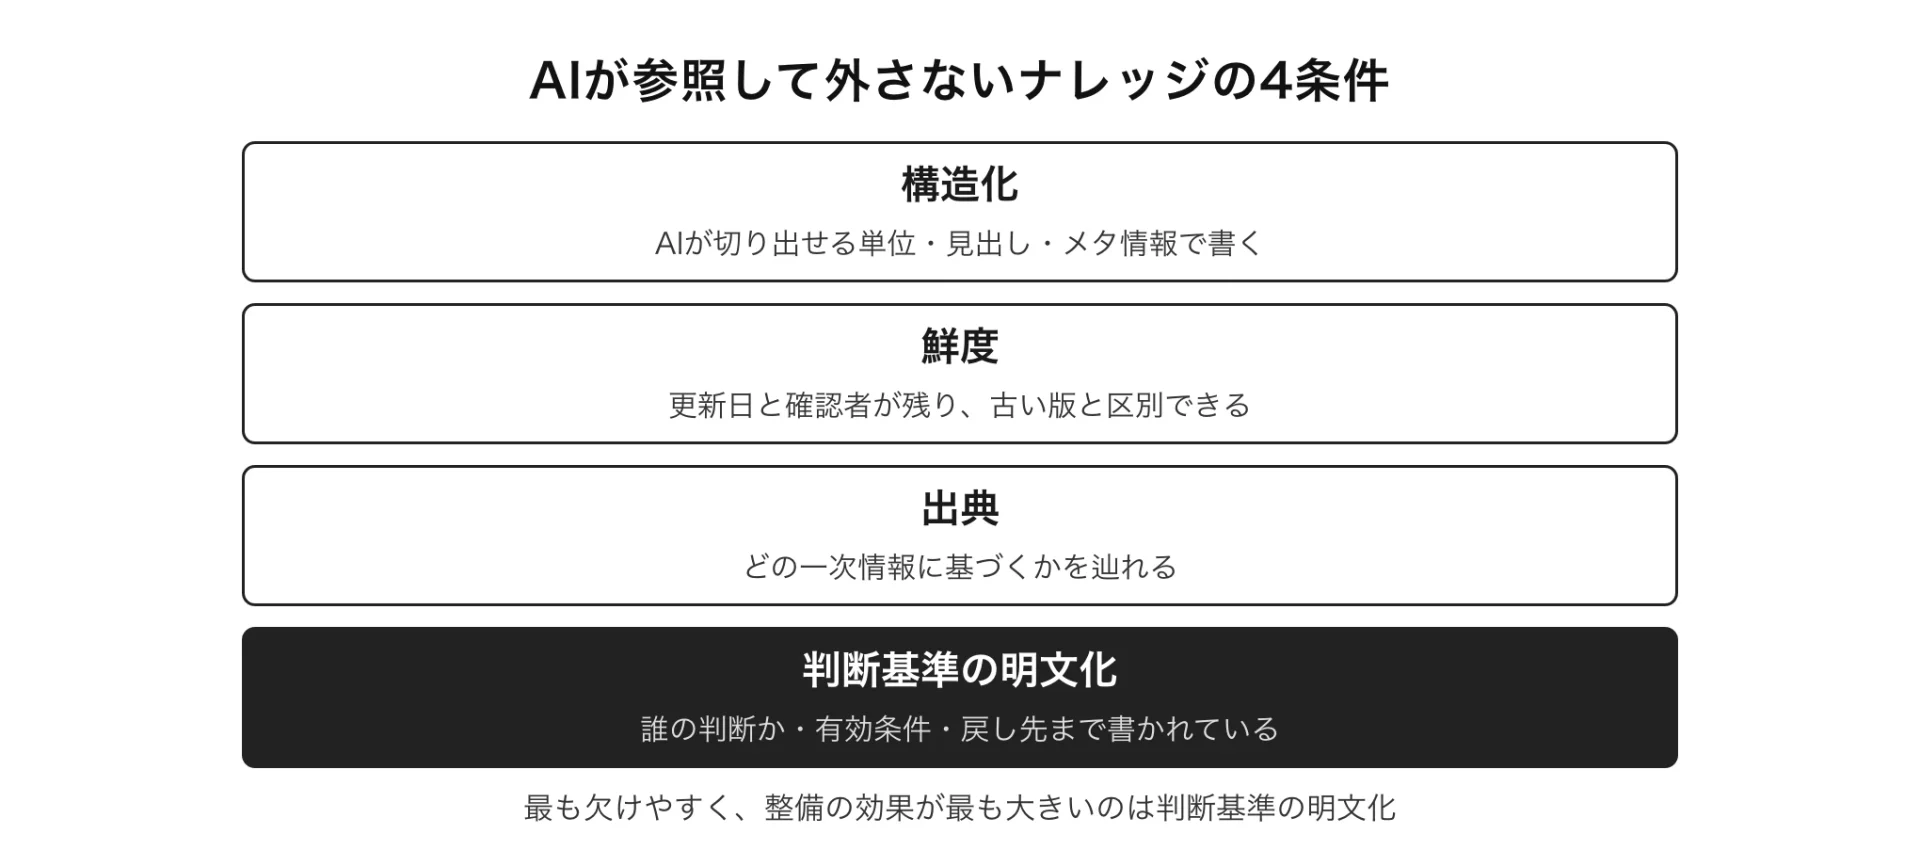
生成AIが参照して外さない文書には、共通する条件があります。全社のデータ戦略のような大きな枠組みではなく、文書を1つずつ点検して直せる単位の条件です。
| 条件 | 内容 | 確認の問い |
|---|---|---|
| 構造化 | AIが切り出せる単位・見出し・メタ情報で書かれている | 1つの見出しの下に1つの主題だけが書かれているか |
| 鮮度 | 更新日と確認者が残り、古い版と区別できる | この文書が現行だと機械にも人にも分かるか |
| 出典 | どの一次情報に基づくかを辿れる | 答えの根拠を人が検証できるか |
| 判断基準の明文化 | 誰の判断か・有効条件・例外時の戻し先が書かれている | 判断を問う質問に文書だけで答えられるか |
構造化で問われるのはAIが切り出せる断片の単位である
RAGは文書を丸ごと読むのではなく、検索で見つけた断片を切り出して材料にします。このため、書き手が意識すべき単位は文書全体ではなく、切り出される断片です。1つの見出しの下には1つの主題だけを書き、結論を段落の冒頭に置き、「前述のとおり」「例の件」のような、その場にいた人にしか分からない指し示しを避けます。断片だけ読まれても意味が通る書き方が、そのままRAGで外れにくい書き方になります。
文書の外側に添える情報も効きます。
- ファイル名とタイトルに業務名と対象を入れる
- 対象業務・対象者・適用条件をメタ情報として冒頭に添える
- 比較や一覧は表にする
逆に、数時間分の議事録や口頭説明の文字起こしをそのまま置いた文書は、どこを切り出しても主題が混ざるため、検索にも生成にも向きません。
鮮度は更新日と確認者を残して初めて管理できる
文書には更新日と、内容を確認した人を残します。人が文書を読むときは日付や文脈から「これは古いかもしれない」と気づけますが、生成AIの答えは要約された形で返るため、根拠の古さが表に出にくくなります。更新日が機械にも読める形で残っていれば、古い文書を参照対象から外す運用や、一定期間更新のない文書を点検に回す運用を組めます。確認者を残すのは、内容の正しさに責任を持つ人を明らかにし、次の更新を依頼する宛先を作るためです。
記録を残して参照可能に保つという方向は、国の指針とも重なります。総務省と経済産業省の「AI事業者ガイドライン(第1.2版)」は、「アカウンタビリティ」の指針として、AIガバナンスに関するポリシーの策定・公表とともに、関係する情報を文書化して一定期間保管し、参照可能な状態にしておくことを挙げています。同ガイドラインは法的義務ではなく事業者の自主的な取組を支援する指針ですが、何を根拠にしたかを後から辿れるようにしておくという考え方は、社内ナレッジの管理にそのまま応用できます。
出典 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」(2026年) https://www.soumu.go.jp/main_content/001064299.pdf
出典を残すのは答えの正しさを人が検証できるようにするためである
文書に書かれた数値や結論には、根拠となった一次情報への参照を残します。元の規程・決裁・契約・試験結果・議事録など、その記述がどこから来たのかを辿れる状態にしておくという意味です。
出典が要るのは、AIの答えを人が検証する場面が必ず残るからです。生成AIツールには回答の参照元文書を示す機能を持つものが多くありますが、示された文書自体に根拠が書かれていなければ、検証はそこで止まります。答えの正しさを確かめる経路は、回答から参照文書へ、参照文書から一次情報へと2段でつながって初めて機能します。加えて、文書同士の内容が食い違ったときに、どちらが正しいかを出典に立ち返って判定できるようにもなります。
判断基準の明文化は4条件のうち最も欠けやすく効果も大きい
手順書やFAQが整っている職場でも、「この場合はどちらを選ぶか」「どの条件なら例外を認めるか」という判断の基準は、担当者の頭の中にだけあって文書になっていないことが珍しくありません。書かれていない基準は検索に乗らず、AIの答えにも現れません。
判断基準を文書にするときは、結論だけを書いても使えません。次の要素を組みにして残します。
- 誰の判断か。判断の主体と帰属をはっきりさせる
- どの条件で有効か。前提が変わったら使えない基準だと分かるようにする
- 例外時に誰へ戻すか。基準の範囲の外に出たときの戻し先を決めておく
担当者によって基準が異なる場合は、平均して1つにまとめず、誰のどの条件での判断かを保ったまま書き分けます。まとめてしまうと、答えの根拠がどちらの基準なのかを後から検証できなくなるためです。
判断基準を書き出すときは、AIと人の役割の線引きも一緒に明文化しておきます。AIが担うのは、文書化された判断基準を参照し、判断に必要な材料を提示するところまでです。判断そのものと結果への責任は人の側に残ります。前掲のAI事業者ガイドラインにも、「公平性」の指針として、AIだけで完結させず適切なタイミングで人間の判断を介在させる利用を検討する、という記載があります。どこまでAIに任せ、例外のときに誰へ戻すのか。この線引きは、AIエージェントが調査や実行まで担う運用が広がるほど避けて通れなくなります。実行するAIに何を渡すかという設計は、別記事「AIエージェント時代のナレッジマネジメント」で扱っています。
既存ナレッジは棚卸し・仕分け・書き直し・測定の4ステップで整える
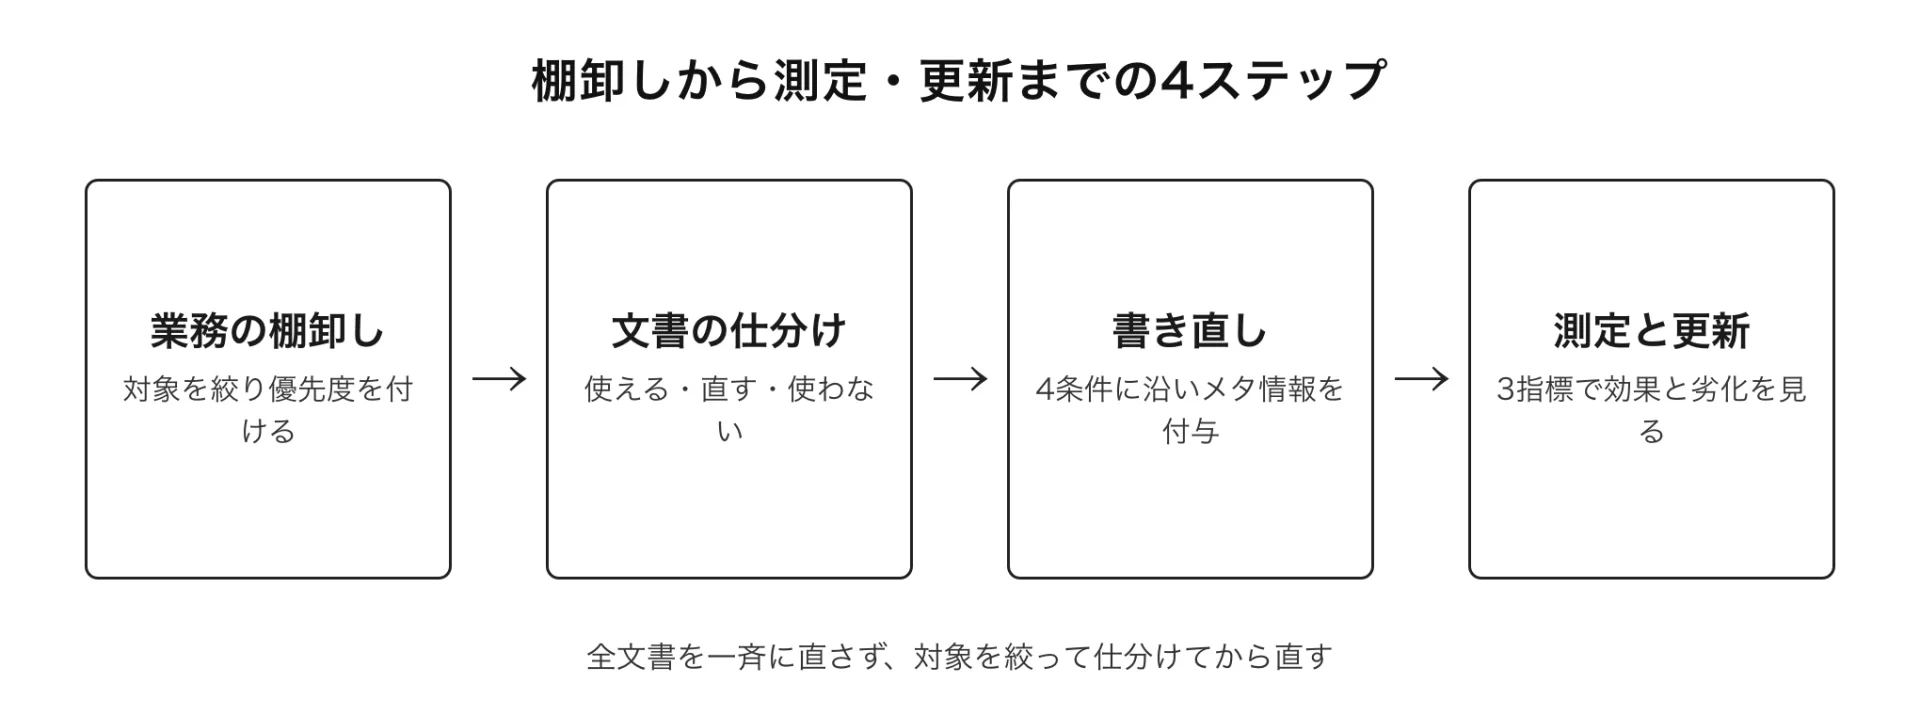
全文書を一斉に直す計画は、途中で止まりがちです。既存のナレッジを4条件へ近づけるときは、対象を絞り、仕分けてから直し、直した後の運用まで決める順で進めます。
最初に決めるのは直す文書ではなく対象業務である
文書単位で見始めると量に圧倒されますが、業務単位なら対象を区切れます。業務ごとに、関係する文書がどこに何件あるか、正本が決まっているか、内容に責任を持つ担当者が誰かを一覧にします。
優先度の見方は次の3点です。
- 問い合わせや確認の発生が多い業務か
- 担当者の異動・退職の予定があるか
- 誤った答えが返ったときの影響が大きい業務か(顧客対応・契約・安全など)
影響の大きい業務ほど整備の効果も大きくなりますが、その分、誤答が許されにくい領域でもあります。最初の1業務には、問い合わせが多く、誤答の影響が限定的な業務を選ぶと進めやすくなります。
既存文書は使える・直す・使わないの3つに仕分ける
対象業務の文書を集めたら、1件ずつ次の3つに分けます。
| 分類 | 基準 | 扱い |
|---|---|---|
| 使える | 内容が現行で、主題の単位が明確、根拠も辿れる | そのまま参照対象に載せる |
| 直す | 内容は有効だが、構造がない・更新日がない・出典が欠けている | 4条件に沿って書き直す |
| 使わない | 旧版・重複・根拠不明 | 参照対象から外す(削除はしない) |
この段階では、まだ文書を1行も書き直していません。それでも、旧版と重複を参照対象から外して正本を決めるだけで、聞くたびに答えが変わる状態は減らせます。使わないと仕分けた文書も削除はせず、参照対象から外すにとどめます。経緯の記録として後から必要になる場合があるからです。
書き直しの中で判断基準の文書化だけは性質が違う
直すと仕分けた文書から、4条件に沿って手を入れます。見出し単位で主題を1つに絞り直し、更新日・確認者・出典を添え、対象業務と適用条件をメタ情報として付けます。全文の書き直しではなく、切り出される単位を整えて足りない情報を足す作業と捉えると、負担を見積もりやすくなります。
判断基準だけは、既存文書のどこにも書かれていないため直す対象がありません。担当者への聞き取りで引き出し、誰の・どの条件での判断かを保った形で新たに書き起こします。ただし、聞き取りで判断を言語化できる範囲には限界があり、すべてを文書にできるわけではありません。どこまで言葉にできるのかは、別記事「暗黙知をAIで形式知化できる範囲」で扱っています。
正答率ではなく根拠提示率・参照率・更新遅延日数で測る
整備した状態は、放置すれば古くなっていきます。効果と劣化を見るための指標を決め、更新を業務の一部に組み込みます。測る候補は次の3つです。
| 指標 | 見るもの | 数値が悪いときに疑うこと |
|---|---|---|
| 根拠提示率 | AIの回答に判断基準・参照資料・前提条件が含まれる割合 | 参照先の文書に根拠や条件が書かれていない |
| 参照率 | 整備した文書が回答の根拠として実際に参照された割合 | 文書が見つけにくい。用語が現場の言葉と合っていない |
| 更新遅延日数 | 業務や制度の変更から文書が更新されるまでの日数 | 更新責任者が決まっていない。変更を拾う仕組みがない |
正答率だけを追わないのが要点です。生成AIの回答から間違いをなくし切ることはできないため、間違いに気づける状態(根拠が示されている)と、気づいたら直る運用(更新が遅れない)を保つほうが、長く使われる仕組みにつながります。
最初に手を付けるのは問い合わせの多い業務である
整備の対象を1業務に絞るなら、社内からの問い合わせが集中している業務を最初に選ぶことをすすめます。理由は2つあります。需要が実証済みであることと、効果を測りやすいことです。
問い合わせの多い業務を選ぶのは需要が実証済みだからである
問い合わせが多い業務は、その情報を必要としている人が現にいることの証明です。整備した文書とAIの回答には初めから使い手がいます。使われるかどうか分からない文書を先回りで整えるのと比べ、徒労に終わる危険が小さい選び方です。
効果の測定にも向いています。問い合わせの件数と内容という導入前の記録が既にあるため、整備後にどれだけ減ったか、答える側の時間がどれだけ浮いたかを比べられます。前章の3指標に加えて、この増減は関係者に伝わりやすい成果になります。さらに、過去の問い合わせと回答のやり取りは、よく聞かれる論点とその答えが対になった蓄積でもあり、文書化の出発点にそのまま使えます。
全社データ基盤の整備から始めない理由は3つある
AI Readyを目指す取り組みは、全社のデータ戦略を立て、データ基盤を構築するところから始めるのが定番の進め方です。中長期の方向としては誤りではありませんが、生成AIに社内ナレッジを参照させて業務の問いに答えさせるという目的に対しては、遠回りになりがちです。
理由は3つあります。第1に、基盤整備は対象が全社に及ぶため、成果が見えるまでの期間が長く、その間に現場の期待が冷めてしまいます。第2に、生成AIの回答品質を決めるのは基盤の性能ではなく、参照される個々の文書の状態です。基盤が立派でも、載っている文書が古く、判断基準が書かれていなければ、答えは外れます。第3に、1つの業務で棚卸しから測定までを回した経験は、対象を広げるときの計画の根拠になりますが、基盤を先に作っても文書整備の経験は貯まりません。
狭い範囲で4条件の整備を回し、測定で効果を確かめてから広げます。IPAの調査でも、導入は広がる一方で効果の実感は限定的でした。範囲は小さくとも成果の出た単位を積み上げるほうが、この落差を避ける進み方になります。
よくある質問
AI ReadyとDXはどう違うのか
DXは、デジタル技術で業務やビジネスモデルを変革する取り組みの全体を指します。AI Readyはその中の到達状態の1つで、AIを導入したときに直ちに活用して成果につなげられる状態を指します。文書が電子化されていてもAI Readyとは限りません。分かれ目は、構造化・鮮度・出典・判断基準の明文化の4条件を満たし、AIが参照して外さない状態になっているかどうかです。
RAGの精度はAIモデルを乗り換えれば上がるのか
参照するデータが同じままなら、大きくは変わりません。RAGの答えは検索で見つかった文書を根拠に組み立てられるため、モデルの性能が上がっても、古い文書は古い答えの根拠になり、書かれていない判断基準は答えに現れないままです。精度に不満があるときは、参照データの散在・古さ・出典不明・判断基準の欠落を先に点検し、それでも残る問題に対してモデルや検索方式の見直しを検討する順序が実務的です。
AI Readyになったかどうかは何で確認できるのか
文書を何件整備したかという投入量ではなく、回答の状態で確認します。目安になるのは、AIの回答に判断基準・参照資料・前提条件が含まれる割合(根拠提示率)、整備した文書が実際に参照された割合(参照率)、変更から文書更新までの日数(更新遅延日数)の3つです。あわせて、判断を問う質問を実際に投げてみて、一般論ではなく自社の条件に基づいた材料が返るかを見ると、判断基準の明文化がどこまで進んだかを確かめられます。
AI Readyは導入の準備ではなくAIが参照して外さない状態である
生成AIの活用でつまずく原因は、モデルの選び方より前に、参照させる社内文書の側にあります。
- AI Readyは2019年の政府決定文書と経団連提言に由来する公的な概念で、必要なときに直ちにAIを導入し便益を得られる状態を指す
- 生成AIの回答が外れる主因はモデルではなく参照データ。散在・古い・出典不明・判断基準の欠落が典型
- AIが参照して外さないナレッジの条件は、構造化・鮮度・出典・判断基準の明文化の4つ
- 整備は、業務の棚卸し→文書の仕分け→書き直しとメタ情報付与→測定と更新運用の4ステップ
- 最初の対象は全社データ基盤ではなく、問い合わせの多い業務。需要が実証済みで、効果も測りやすい
4条件のうち構造化・鮮度・出典は、既にある文書の手入れで近づけます。判断基準の明文化だけは、書かれていないものを聞き取りで引き出して新たに書き起こす、性質の違う仕事です。手順への質問には正確に答えるのに、判断を問うと一般論しか返らない。生成AIの活用でいちばん気づきにくいこの差を埋められるのも、判断基準の明文化だけです。次に自社のナレッジ整備を検討するときは、問い合わせの多い業務を1つ選び、その業務の文書が4条件をどこまで満たしているかを確かめるところから始めてみてください。
SNSでシェアする


各種お問い合わせ